가상 면접 사례로 배우는 대규모 시스템 설계 기초 - 1장
1. 사용자 수에 따른 규모 확장성
-
단일 서버
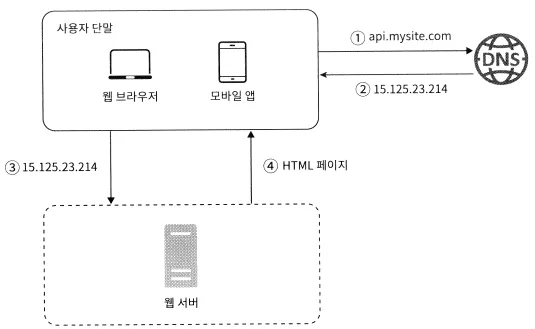
- 사용자 요청이 처리 흐름
- 사용자는 도메인 이름을 이용하여 웹사이트에 접속
- DNS 조회 결과로 IP 주소가 반환
- 해당 IP 주소로 HTTP 요청 전달
- 요청을 받은 웹 서버는 HTML 페이지나 JSON 형태의 응답 반환
- 실제 요청이 오는 단말
- 웹 애플리케이션
- 비즈니스 로직, 데이터 저장 등을 처리하기 위해 서버 구현용 언어를 사용하고, 프레젠테이션용으로 클라이언트 구현용 언어를 사용
- 모바일 앱
- 모바일 앱과 웹 서버 간 통신을 위해 HTTP 프로토콜을 이용
- HTTP 프로토콜을 통해서 반환될 응답 데이터의 포맷으로는 보통 JSON 사용
- 웹 애플리케이션
- 사용자 요청이 처리 흐름
-
데이터베이스
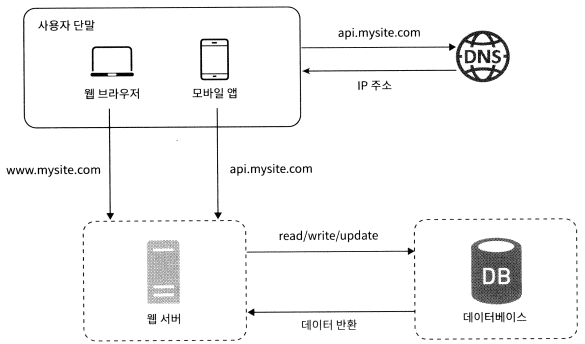
- 사용자가 늘면 서버 하나로는 충분하지 않아서 여러 서버를 두어야 함
- 하나는 웹/모바일 트래픽 처리 용도. 다른 하나는 DB용
- 어떤 DB를 사용할 것인가?
- 관계형 DB
- RDBMS라고도 부름
- 비관계형 DB
- NoSQL이라고도 부름
- 종류
- 키-값 저장소
- 그래프 저장소
- 칼럼 저장소
- 문서 저장소
- 일반적으로 조인 연산은 지원하지 않음
- 아래와 같은 경우 비관계형 DB가 적절함
- 아주 낮은 응답 지연시간 요구
- 다루는 데이터가 비정형이라 관계형 데이터가 아님
- 데이터를 직렬화하거나 역직렬화 할 수 있기만 하면 됨
- 아주 많은 양의 데이터를 저장할 필요가 있음
- 관계형 DB
-
규모 확장
- 수직적 규모 확장(Vertical Scaling)
- 스케일 업(Scale Up)이라고도 함
- 서버에 고사양 자원을 추가하는 행위
- 수평적 규모 확장(Horizontal Scaling)
- 스케일 아웃(Scale Out)이라고도 함
- 더 많은 서버를 추가하여 성능을 개선하는 행위
- 수직적 규모 확장의 한계
- 수직적 규모 확장에는 한계가 있음. 한 대의 서버에 CPU나 메모리를 무한대로 증설할 수 없음
- 장애에 대한 자동복구(Failover) 방안이나 다중화(Redundancy) 방안을 제시하지 않음. 서버에 장애가 발생하면 웹사이트/앱은 완전히 중단
- 이러한 단점으로 대규모 애플리케이션을 지원하는 데는 수평적 규모 확장이 적절
- 수직적 규모 확장(Vertical Scaling)
-
로드밸런서
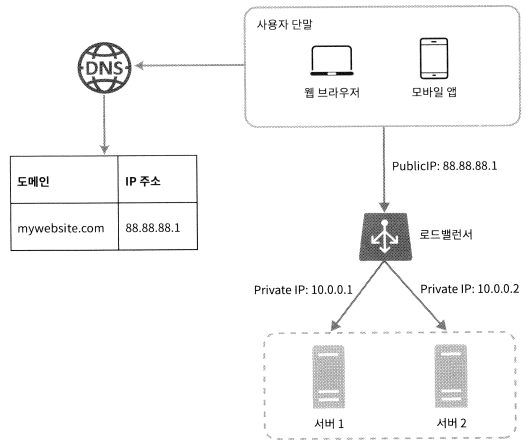
- 부하 분산 집합(Load Balancing Set)에 속한 웹 서버들에게 트래픽 부하를 고르게 분산하는 역할을 함
- 사용자는 로드밸런서의 공개 IP 주소로 접속 → 웹 서버는 클라이언트의 접속을 직접 처리하지 않음 → 보안을 위해 서버 간 통신에는 사설 IP 주소가 이용됨
- 부하 분산 집합에 또 하나의 웹 서버를 추가하면 장애 자동복구 문제는 해소되며 가용성 향상
- 서버 1이 다운되면 모든 트래픽은 서버2로 전송 → 웹 사이트 전체가 다운되는 일이 방지됨
- 웹 사이트로 유입되는 트래픽이 가파르게 증가하면 두 대의 서버로 트래픽이 감당이 안될 수 있는데, 로드밸런서가 있으므로 더 많은 서버를 추가하기만 하면 됨 → 로드밸런서가 자동으로 트래픽을 분산
-
데이터베이스 다중화
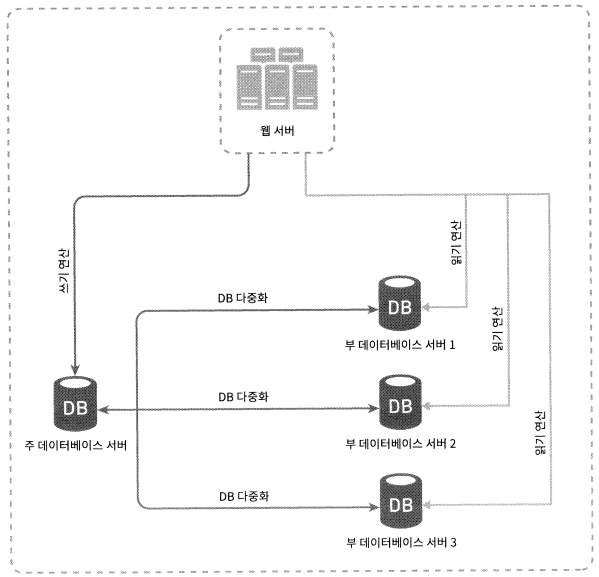
-
보통은 서버 사이에 주(Master)-부(Slave) 관계를 설정하고 데이터 원본은 주 서버에, 사본은 부 서버에 저장
-
쓰기 연산은 마스터에서만 지원. 부 데이터베이스는 주 데이터베이스로부터 사본을 전달받으며 읽기 연산만을 지원
-
따라서 통상 부 데이터베이스는 주 데이터베이스의 수보다 많음
-
DB 다중화의 장점
- 더 나은 성능
- 주-부 다중화 모델에서 모든 데이터 변경 연산은 주 DB 서버로만 전달되는 반면 읽기 연산은 부 DB 서버들로 분산
- 병렬로 처리될 수 있는 query의 수가 늘어나므로 성능이 좋아짐
- 안정성(Reliability)
- 자연 재해 등의 이유로 DB 서버 가운데 일부가 파괴되어도 데이터 보존
- 데이터를 지역적으로 떨어진 여러 장소에 다중화시켜 놓을 수 있음
- 가용성(Availability)
- 데이터를 여러 지역에 복제해 둠으로써, 하나의 DB 서버에 장애가 발생하더라도 다른 서버에 있는 데이터를 가져와 계속 서비스 할 수 있게 함
- 더 나은 성능
-
DB 서버 중 하나가 다운되는 경우
- 부 서버 다운
- 부 서버가 한 대 뿐인데 다운된 경우 → 읽기 연산은 한시적으로 모두 주 DB로 전달
- 부 서버가 여러 대인 경우 → 읽기 연산은 나머지 부 DB 서버들로 분산
- 주 서버 다운
- 한 대의 부 DB만 있는 경우 → 해당 부 DB가 새로운 주 서버가 됨
- 프로덕션(Production) 환경
- 부 서버에 보관된 데이터가 최신 상태가 아닐 수 있음
- 없는 데이터는 복구 스크립트(Recovery Script)를 돌려서 추가
- 다중 마스터(Multi-Master)나 원형 다중화(Circular Replication) 방식을 도입하면 이러한 상황에 대처하는데 도움이 될 수 있으나 구성은 훨씬 복잡함
- 프로덕션(Production) 환경
- 한 대의 부 DB만 있는 경우 → 해당 부 DB가 새로운 주 서버가 됨
- 부 서버 다운
-
로드 밸런서와 DB 다중화를 고려한 설계
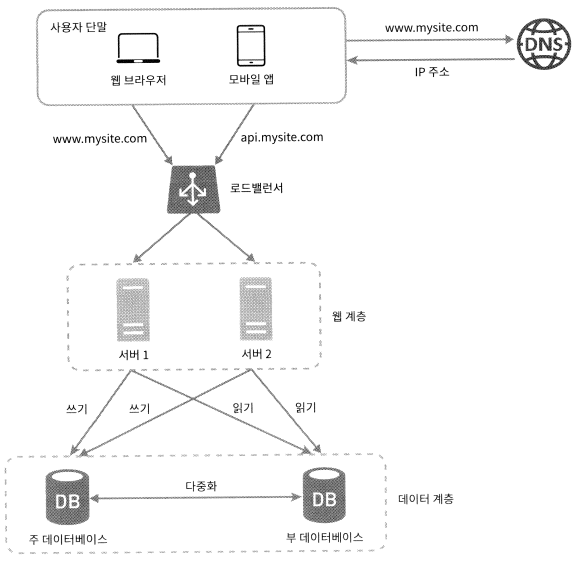
- 사용자는 DNS로부터 로드밸런서의 공개 IP 주소를 받음
- 사용자는 해당 IP 주소를 사용해 로드밸런서에 접속
- HTTP 요청은 서버 1이나 서버 2로 전달
- 웹 서버는 사용자의 데이터를 부 DB 서버에서 읽음
- 웹 서버는 데이터 변경 연산은 주 DB로 전달
-
-
캐시
-
값비싼 연산 결과 또는 자주 참조되는 데이터를 메모리 안에 두고, 뒤이은 요청이 보다 빨리 처리될 수 있도록 하는 저장소
-
캐시 계층(Cache Tier)
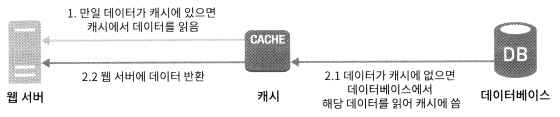
- 데이터가 잠시 보관되는 곳으로 DB보다 훨씬 빠름
- 캐시 계층을 두면 성능이 개선되고, DB의 부하를 줄임
- 요청받은 웹 서버는 캐시에 응답이 저장되어 있는지 확인
- 저장되어 있다면 해당 데이터를 클라이언트에 반환 → 캐시 우선 읽기 전략(Read-Through Caching Strategy)
-
캐시 사용 시 고려할 사항
-
데이터 갱신은 자주 일어나지 않지만 참조는 빈번하게 일어나는 경우
-
영속적으로 보관할 데이터는 캐시에 두지 바람직하지 않음
-
보관된 데이터에 대한 만료 정책
- 만료된 데이터는 캐시에서 삭제되어야 함
- 만료 기한이 너무 짧으면 DB를 너무 자주 읽게 되고, 너무 길면 원본과 차이가 날 수 있음
-
일관성 유지
- 저장소의 원본을 갱신하는 연산과 캐시를 갱신하는 연산이 단일 트랜잭션으로 처리되지 않는 경우 일관성이 깨질 수 있음
-
장애 대처
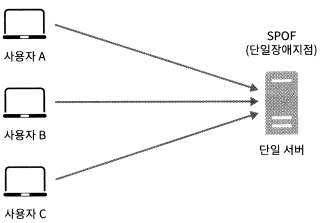
- 캐시 서버를 한 대만 두는 경우 해당 서버는 단일 장애 지점(SPOF, Single Point of Failure)이 되어버릴 수 있음
- 단일 장애 지점
- 어떤 특정 지점에서의 장애가 전체 시스템의 동작을 중단시켜버릴 수 있는 경우
- SPOF를 피하려면 여러 지역에 걸쳐 캐시 서버를 분산시켜야 함
-
캐시 메모리의 크기
- 캐시 메모리가 너무 작으면 데이터가 자주 캐시에서 밀려나버려 캐시의 성능이 떨어짐
-
데이터 방출 정책
- 캐시가 꽉 찼을 때 추가로 캐시에 데이터를 넣어야 할 경우 기존 데이터를 내보내야 함
- LRU, LFU, FIFO 등
-
-
-
콘텐츠 전송 네트워크(Content Delivery Network)
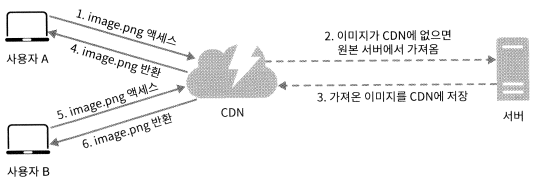
-
정적 콘텐츠를 전송하는데 쓰이는 분산된 서버의 네트워크
-
사용자에게 가장 가까운 CDN 서버가 정적 콘텐츠 전달
-
동작 순서
- 사용자 A가 URL을 이용해 image.png에 접근. URL의 도메인은 CDN 서비스 사업자가 제공
- CDN 서버의 캐시에 해당 이미지가 없는 경우, 서버는 원본 서버에 요청하여 파일을 가져옴
- 원본 서버가 파일을 CDN 서버에 반환. 응답의 HTTP 헤더에는 해당 파일이 얼마나 오래 캐시될 수 있는지 설명하는 TTL 값이 들어있음
- CDN 서버는 파일을 캐시하고 사용자 A에게 반환
- 사용자 B가 같은 이미지에 대한 요청을 CDN 서버에 전송
- 만료되지 않은 이미지에 대한 요청은 캐시를 통해 처리
-
CDN 사용 시 고려할 사항
- 비용
- CDN은 보통 제3 사업자에 의해 운영
- CDN으로 들어가고 나가는 데이터 전송 양에 따라 요금을 냄
- 자주 사용되지 않는 콘텐츠를 캐싱하는 것은 이득이 크지 않으므로 CDN에서 빼는 것을 고려
- 적절한 만료 시한 설정
- 시의성이 중요한 콘텐츠의 경우 만료 시점을 잘 정해야 함
- 너무 길면 신선도가 떨어지고, 너무 짧으면 원본 서버에 빈번히 접속해야 함
- CDN 장애에 대한 대처 방안
- CDN 자체가 죽었을 경우 웹사이트/애플리케이션이 어떻게 동작해야 하는지 고려해야 함
- 콘텐츠 무효화
- 아직 만료되지 않은 콘텐츠라 하더라도 CDN에서 제거할 수 있음
- CDN 서비스 사업자가 제공하는 API를 이용하여 콘텐츠 무효화
- 콘텐츠의 다른 버전을 서비스하도록 오브젝트 버저닝(Object Versioning) 이용. 콘텐츠의 새로운 버전을 지정하기 위해 URL 마지막에 버전 번호를 인자로 주면 됨
- 아직 만료되지 않은 콘텐츠라 하더라도 CDN에서 제거할 수 있음
- 비용
-
CDN과 캐시가 추가된 설계
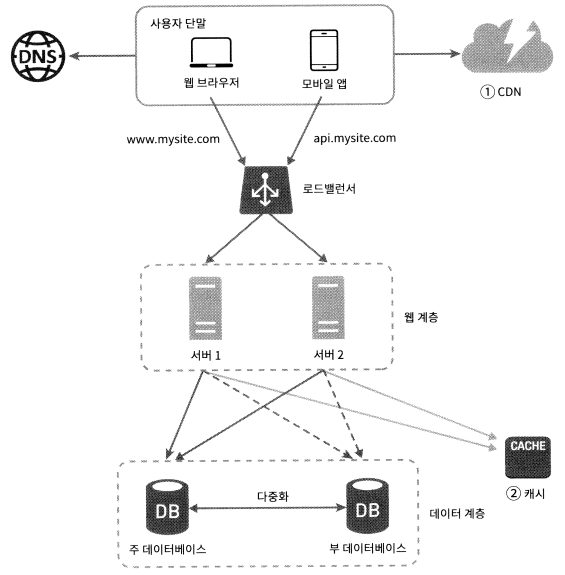
- 정적 콘텐츠는 더 이상 웹 서버를 통해 서비스하지 않으며, CDN을 통해 제공하여 더 나은 성능 보장
- 캐시가 데이터베이스 부하를 줄여줌
-
-
무상태(Stateless) 웹 계층
-
웹 계층을 수평적으로 확장하기 위해 상태 정보를 웹 계층에서 제거해야 함
-
상태 정보 의존 아키텍처
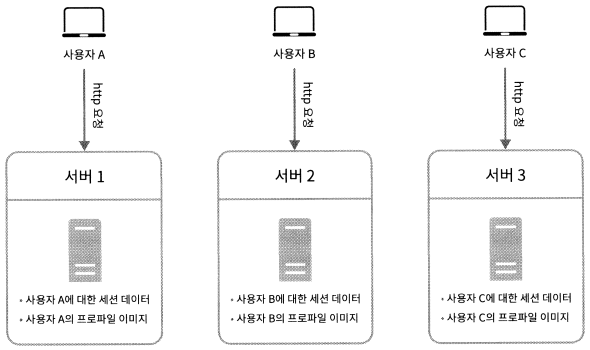
- 서버는 클라이언트 정보, 즉 상태를 유지하여 요청들 사이에 공유되도록 함
- 같은 클라이언트로부터의 요청은 항상 같은 서버로 전송되어야 함
- 대부분의 로드밸런서가 이를 지원하기 위해 고정 세션(Sticky Session)이라는 기능을 제공하는데, 이는 로드밸런서에 부담을 주고 로드밸런서 뒤에 서버를 추가하거나 제거하기 까다로워짐
-
무상태 아키텍처
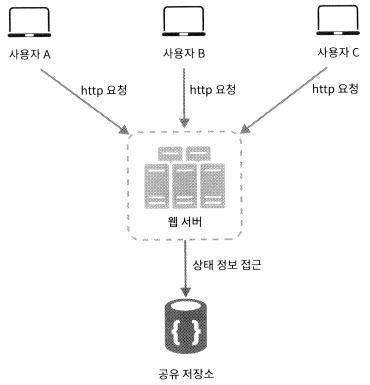
- 사용자로부터의 HTTP 요청은 어떤 웹 서버로도 전달될 수 있음
- 웹 서버는 상태 정보가 필요할 경우 공유 저장소(Shared Storage)로부터 데이터를 가져옴 → 상태 정보는 웹 서버로부터 물리적으로 분리
- 단순하고, 안정적이며 규모 확장이 쉬움
-
무상태 웹 계층을 갖도록 설계를 변경
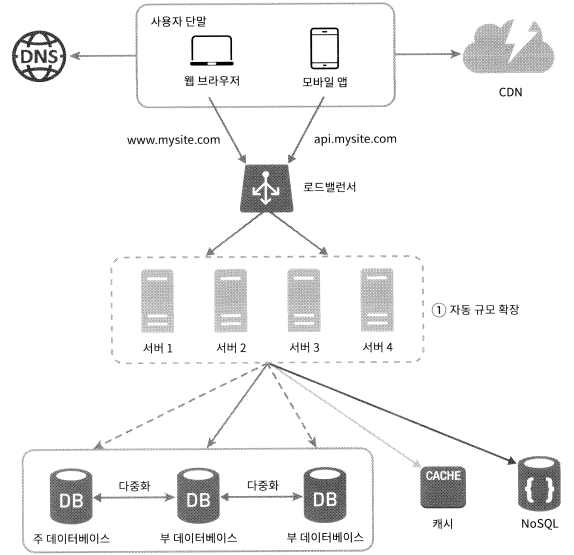
- 세션 데이터를 웹 계층에서 분리하고 지속성 데이터 보관소에 저장하도록 만듦
-
-
데이터 센터
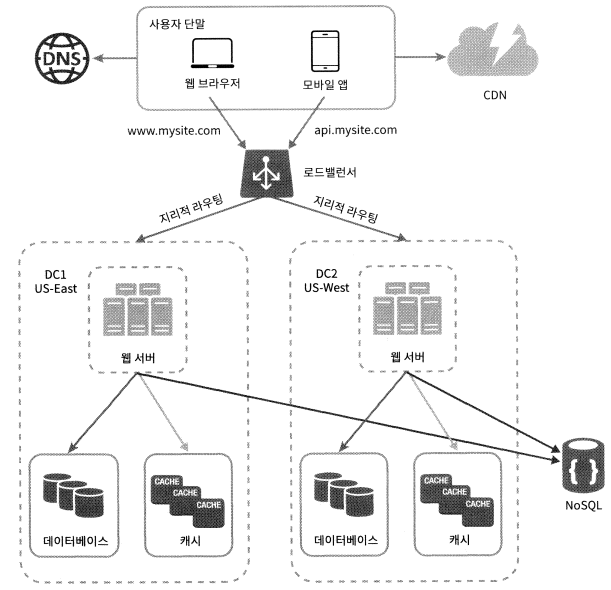
- 지리적 라우팅(geoDNS-Routing 또는 get-routing)
- 장애가 없는 상황에서 사용자는 가장 가까운 데이터 센터로 안내됨
- 사용자의 위치에 따라 도메인 이름을 어떤 IP 주소로 변환할지 결정할 수 있도록 해주는 DNS 서비스
- 데이터 센터 중 하나에 심각한 장애가 발생하면 모든 트래픽은 장애가 없는 데이터 센터로 전송
- 다중 데이터센터 아키텍처를 만들려면 몇 가지 기술적 난제를 해결해야 함
- 트래픽 우회
- 올바른 데이터 센터로 트래픽을 보내는 효과적인 방법을 찾아야 함
- GeoDNS는 사용자에게서 가장 가까운 데이터센터로 트래픽을 보낼 수 있게 함
- 데이터 동기화(Synchronization)
- 데이터 센터마다 별도의 데이터베이스를 사용한다면, 장애가 자동으로 복구되어 트래픽이 다른 데이터베이스로 우회된다 해도, 데이터가 없을 수 있음
- 이런 상황을 막는 보편적 전략은 데이터를 여러 데이터센터에 걸쳐 다중화하는 것
- 테스트와 배포
- 여러 데이터 센터를 사용하도록 시스템이 구성되었다면 여러 위치에서 테스트해봐야 함
- 트래픽 우회
- 지리적 라우팅(geoDNS-Routing 또는 get-routing)
-
메시지 큐
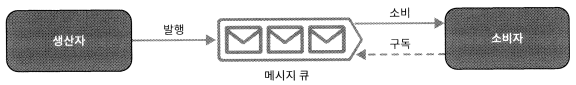
- 메시지의 무손실(Durability)을 보장하는 비동기 통신(Asynchronous Communication)을 지원하는 컴포넌트
- 메시지의 버퍼 역할을 하며 비동기적으로 전송
- 생산자 또는 발행자라고 불리는 입력 서비스가 메시지를 만들어 메시지 큐에 발행
- 큐에는 보통 소비자 혹은 구독자라 불리는 서비스 혹은 서버가 연결되어 있는데, 메시지를 받아 그에 맞는 동작을 수행
- 메시지 큐를 이용하면 서비스 또는 서버 간 결합이 느슨해져서 규모 확장성이 보장되어야 하는 안정적 애플리케이션을 구성하기 좋음
- 생산자는 소비자 프로세스가 다운되어 있어도 메시지를 발행할 수 있고, 소비자는 생산자 서비스가 가용한 상태가 아니더라도 메시지를 수신할 수 있음
-
로그, 메트릭, 자동화
-
로그
- 에러 로그를 모니터링하는 것은 중요. 시스템의 오류와 문제들을 보다 쉽게 찾아낼 수 있도록 하기 때문
- 에러 로그는 서버 단위로 모니터링 할 수 있지만, 로그를 단일 서비스로 모아주는 도구를 활용하면 더 편리하게 검색하고 조회할 수 있음
-
메트릭
- 메트릭을 잘 수집하면 사업 현황에 관한 유용한 정보를 얻을 수 있고, 시스템의 현재 상태를 손쉽게 파악할 수 있음
- 호스트 단위 메트릭
- CPU, 메모리, 디스크 I/O에 관한 메트릭
- 종합(Aggregated) 메트릭
- 데이터베이스 계층의 성능, 캐시 계층의 성능 등
- 핵심 비즈니스 메트릭
- 일별 능동 사용자, 수익, 재방문 등
-
자동화
- 시스템이 크고 복잡해지면 생산성을 높이기 위해 자동화 도구를 활용해야 함
- 지속적 통합을 도와주는 도구를 활용하면 개발자가 만드는 코드가 어떤 검증 절차를 자동으로 거치도록 할 수 있어서 문제를 쉽게 감지할 수 있음
-
메시지 큐, 로그, 메트릭, 자동화 등을 반영한 설계
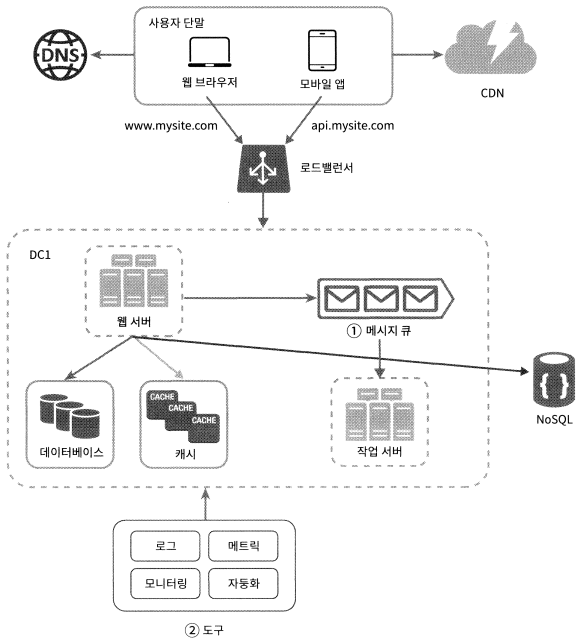
- 메시지 큐는 각 컴포넌트가 보다 느슨한 결합이 될 수 있도록 하고, 결함에 대한 내성을 높임
- 로그, 모니터링, 메트릭, 자동화 등을 지원하기 위한 장치를 추가
-
-
데이터베이스 규모 확장
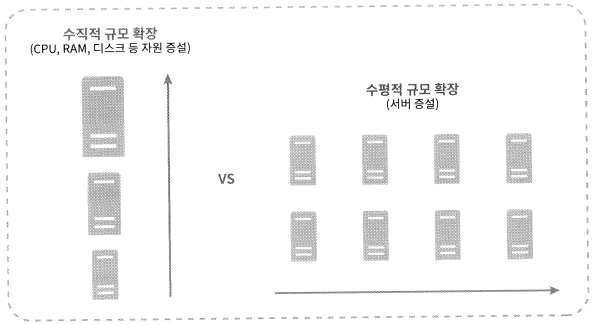
-
수직적 확장
- 스케일 업이라고도 함
- 기존 서버에 더 많은, 또는 더 고성능의 자원을 증설하는 방법
- 단점
- 서버 HW에는 한계가 있으므로 무한히 증설할 수 없음
- SPOF로 인한 위험성이 큼
- 비용이 많이 듦
-
수평적 확장
- 샤딩이라고도 함
- 더 많은 서버를 추가하여 성능을 향상
- 데이터베이스를 샤드(Shard)라고 부르는 작은 단위로 분할
- 모든 샤드는 같은 스키마를 쓰지만 샤드에 보관되는 데이터 사이에는 중복이 없음
- 샤딩 전략을 구현할 때 고려해야 할 가장 중요한 것은 샤딩 키(Sharding Key)를 어떻게 정하는지
- 샤딩 키는 파티션 키(Partition Key)라고도 부르는데, 데이터가 어떻게 분산될지 정하는 하나 이상의 칼럼으로 구성 → 샤딩 키를 정할 때 데이터를 고르게 분할 할 수 있도록 하는게 가장 중요
- 단점
- 데이터의 재 샤딩(Resharding)
- 재 샤딩은 다음과 같은 경우 필요
- 데이터가 너무 많아져서 하나의 샤드로는 더 이상 감당하기 어려울 때
- 샤드 간 데이터 분포가 균등하지 못하여 어떤 샤드에 할당된 공간 소모가 다른 샤드에 비해 빨리 진행될 때
- 샤드 소진(Shard Exhaustion)이라고도 부르는 이런 현상이 발생하면 샤드 키를 계산하는 함수를 변경하고 데이터를 재배치해야 함
- 안정 해시(Consistent Hashing) 기법을 활용하면 문제 해결 가능
- 재 샤딩은 다음과 같은 경우 필요
- 유명인사(Celebrity) 문제
- 핫스팟 키 문제라고도 함
- 특정 샤드에 질의가 집중되어 서버에 과부하가 걸리는 문제
- 케이티 페리, 레이디 가가, 저스틴 비버가 같은 샤드에 저장되는 DB가 있다면 read 연산때문에 과부하가 걸릴 것
- 조인과 비정규화(Join and Denormalization)
- 하나의 데이터베이스를 여러 샤드 서버로 쪼개고 나면, 여러 샤드에 걸친 데이터를 조인하기 힘들어짐
- 데이터베이스를 비정규화하여 하나의 테이블에서 질의가 수행될 수 있도록 하여 해결
- 데이터의 재 샤딩(Resharding)
-
샤딩을 적용한 아키텍처
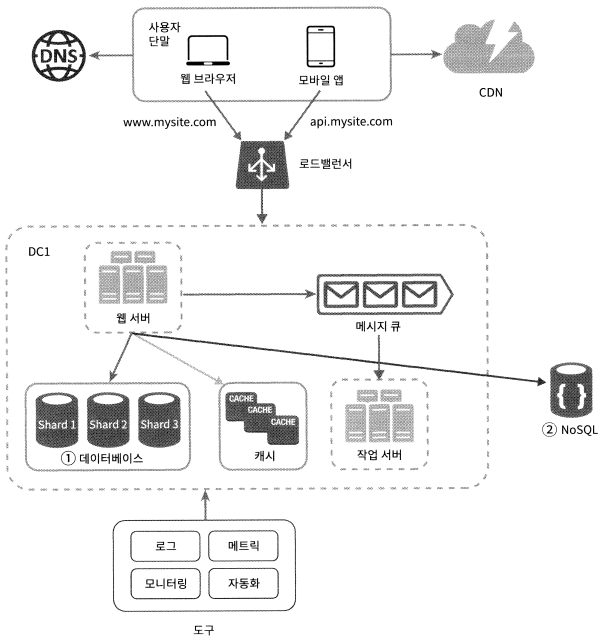
-
-
백만 사용자, 그리고 그 이상
- 시스템의 규모를 확장하는 것은 지속적이고 반복적인 과정
- 시스템 규모 확장을 위한 기법 정리
- 웹 계층은 무상태 계층으로
- 모든 계층에 다중화 도입
- 가능한 한 많은 데이터를 캐시할 것
- 여러 데이터 센터를 지원할 것
- 정적 콘텐츠는 CDN을 통해 서비스할 것
- 데이터 계층은 샤딩을 통해 그 규모를 확장할 것
- 각 계층은 독립적 서비스로 분할할 것
- 시스템을 지속적으로 모니터링하고, 자동화 도구들을 활용할 것