가상 면접 사례로 배우는 대규모 시스템 설계 기초 - 2장
2. 개략적인 규모 추정
-
개략적인 규모 추정(Back of the Envelope Estimation)은 보편적으로 통용되는 성능 수치상에서 사고 실험(Thought Experiments)을 행하여 추정치를 계산하는 행위로서, 어떤 설계가 요구사항에 부합할 것인지 보기 위한 것
-
개략적 규모 추정을 효과적으로 해내려면 규모 확장성을 표현하는데 필요한 기본기에 능숙해야 함
- 특히 2의 제곱수나 응답지연(Latency) 값, 그리고 가용성에 관계된 수치들을 기본적으로 잘 이해하고 있어야 함
-
2의 제곱수
2의 X제곱 근사치 이름 축약형 10 1천(Thousand) 1킬로바이트(Kilobyte) 1KB 20 1백만(Million) 1메가바이트(Megabyte) 1MB 30 10억(Billion) 1기가바이트(Gigabyte) 1GB 40 1조(Trillion) 1테라바이트(Terabyte) 1TB 50 1000조(Quadrillion) 1페타바이트(Petabyte) 1PB -
응답지연 값
- ns = nanosecond(나노초), μs = microsecond(마이크로초), ms = millisecond(밀리초)
- 1ns = 10⁻⁹, 1μs = 10⁻⁶ = 1000ns, 1ms = 10⁻³ = 1000μs = 1000000ns
연산명 시간 L1 캐시 참조 0.5ns 분기 예측 오류(Branch Mispredict) 5ns L2 캐시 참조 7ns 뮤텍스 락/언락 100ns 주 메모리 참조 100ns Zippy로 1KB 압축 10000ns = 10μs 1Gbps 네트워크로 2KB 전송 20000ns = 20μs 메모리에서 1MB 순차적으로 read 250000ns = 250μs 같은 데이터 센터 내에서의 메시지 왕복 지연 시간 50000ns = 500μs 디스크 탐색(Seek) 10000000ns = 10ms 네트워크에서 1MB 순차적으로 read 10000000ns = 10ms 디스크에서 1MB 순차적으로 read 30000000ns = 30ms 한 패킷의 켈리포니아로부터 네덜란드까지의 왕복 지연시간 150000000ns = 150ms -
2020년 기준으로 시각화한 수치
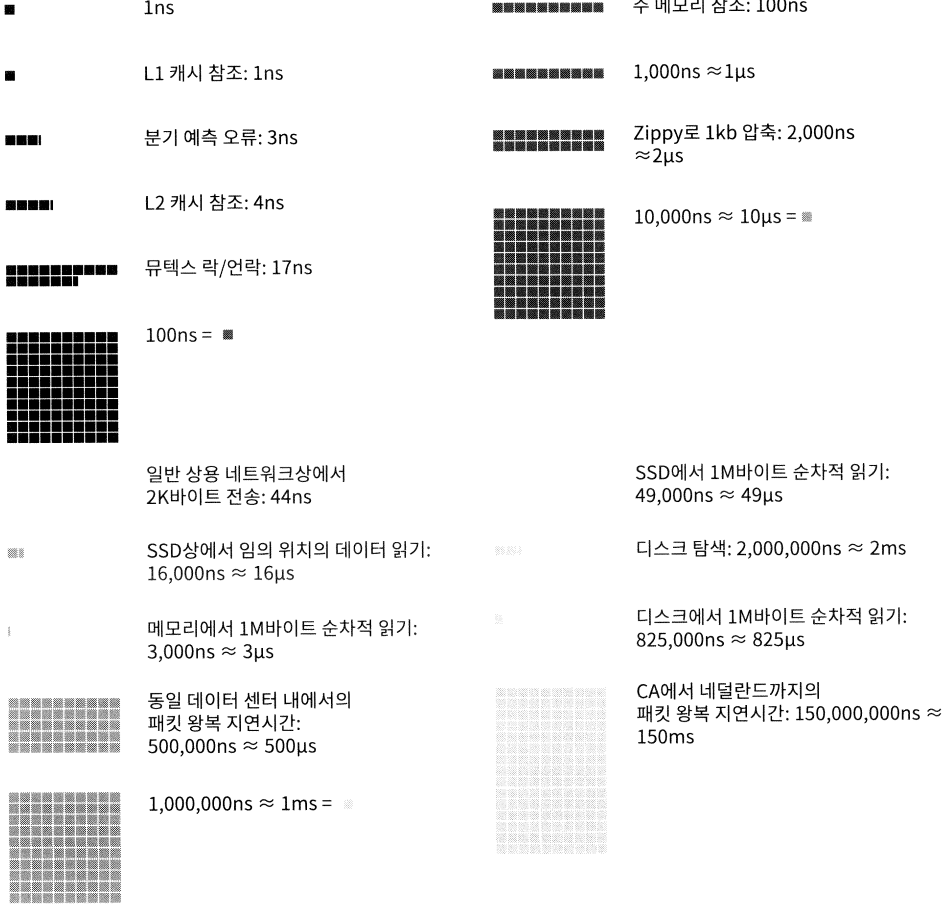
- 메모리는 빠르지만 디스크는 아직도 느림
- 디스크 탐색(Seek)는 가능한 한 피하기
- 단순한 압축 알고리즘은 빠름
- 데이터를 인터넷으로 전송하기 전에 가능하면 압축할 것
- 데이터 센터는 보통 여러 지역에 분산되어 있고, 센터들 간에 데이터를 주고받는 데는 시간이 걸림
-
가용성에 관계된 수치들
- 고가용성(High Availability)
- 시스템이 오랜 시간 동안 지속적으로 중단 없이 운영될 수 있는 능력
- 퍼센트로 표현
- 100%는 시스템이 단 한 번도 중단된 적이 없었음을 의미
- 대부분의 서비스는 99% ~ 100% 사이의 값을 가짐
- SLA(Service Level Agreement)
- 서비스 사업자(Service Provider)가 보편적으로 사용하는 용어
- 서비스 사업자와 고객 사이에 맺어진 합의를 의미
- 서비스 사업자가 제공하는 서비스의 가용시간(Uptime)이 공식적으로 기술
- 가용률과 시스템 장애시간(Downtime) 사이의 관계
가용률 하루당 장애시간 주당 장애시간 개월당 장애시간 연간 장애시간 99% 14.40분 1.68시간 7.31시간 3.65일 99.9% 1.44분 10.08분 43.83분 8.77시간 99.99% 8.64초 1.01분 4.38분 52.60분 99.999% 864.00밀리초 6.05초 26.30초 5.26분 99.9999% 86.40밀리초 604.80밀리초 2.63초 31.56초
- 고가용성(High Availability)
-
예제 : QPS와 저장소 요구량 추정
- 가정
- 월간 능동 사용자(MAU, Monthly Active User)는 3억명임
- 50%의 사용자가 트위터를 매일 사용함
- 평균적으로 각 사용자는 매일 2건의 트윗을 올림
- 미디어를 포함하는 트윗은 10% 정도임
- 데이터는 5년간 보관함
- 추정
- QPS(Query Per Second) 추정치
- 일간 능동 사용자(DAU, Daily Active User) = 3억 * 50% = 1.5억
- QPS = 1.5억 * 2억 트윗 / 24시간 / 3600초 = 약 3500
- 최대 QPS(Peek QPS) = 2 * QPS = 약 7000
- 미디어 저장을 위한 저장소 요구량
- 평균 트윗 크기
- tweet_id에 64바이트
- 텍스트에 140바이트
- 미디어에 1MB
- 미디어 저장소 요구량
- 1.5억 * 2 * 10% * 1MB = 30TB/일
- 5년간 미디어를 보관하기 위한 저장소 요구량
- 30TB * 365 * 5 = 약 55PB
- 평균 트윗 크기
- QPS(Query Per Second) 추정치
- 가정
-
팁
- 가장 중요한 것은 문제를 풀어나가는 절차
- 근사치를 활용한 계산(Rounding and Approximation)
- 면접장에서 복잡한 계산을 하기는 어려움
- 99987 / 9.1 → 100000 / 10으로 간소화
- 가정(Assumption)들은 나중에 살펴볼 수 있도록 적어 두기
- 단위(Unit)를 붙이기 → 5라고만 적으면 5KB인지 5MB인지 알 수 없음
- 많이 출제되는 개략적 규모 추정 문제는 QPS, 최대 QPS, 저장소 요구량, 캐시 요구량, 서버 수 등을 추정하는 것