가상 면접 사례로 배우는 대규모 시스템 설계 기초 - 4장
4. 처리율 제한 장치의 설계
- 처리율 제한 장치(Rate Limiter)
- 클라이언트 또는 서비스가 보내는 트래픽의 처리율을 제어하기 위한 장치
- API 요청 횟수가 제한 장치에 정의된 임계치(Threshold)를 넘어서면 추가로 도달한 모든 호출은 처리가 중단
- API에 처리율 제한 장치를 두면 좋은 점
- DoS(Denial of Service) 공격에 의한 자원 고갈(Resource Starvation)을 방지할 수 있음
- 비용 절감
- 추가 요청에 대한 처리를 제한하면 서버를 많이 두지 않아도 되고, 우선순위가 높은 API에 더 많은 자원을 할당 할 수 있음
- 서버 과부하를 막음
- Bot에서 오는 트래픽이나 사용자의 잘못된 이용 패턴으로 유발된 트래픽을 걸러냄
-
문제 이해 및 설계 범위 확정
- 처리율 제한 장치를 구현하는 데 여러 가지 알고리즘 사용 가능
- 면접관과 소통하며 어떤 제한 장치를 구현해야 하는지 분명히 할 것
-
개략적 설계안 제시 및 동의 구하기
- 처리율 제한 장치는 어디에 둘 것인가?
- 클라이언트
- 일반적으로 클라이언트는 처리율 제한을 안정적으로 걸 수 있는 장소가 아님 → 클라이언트 요청은 쉽게 위변조가 가능하기 때문
- 서버
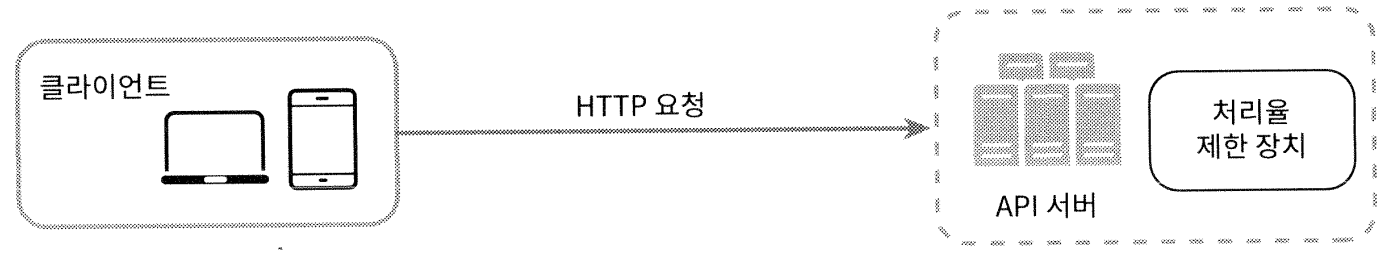
- 미들웨어
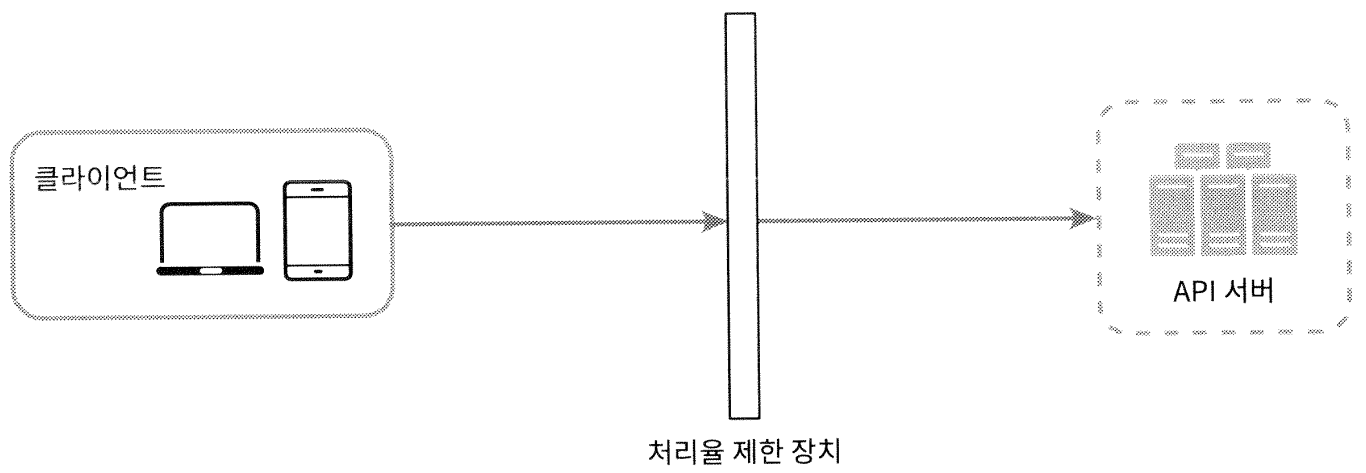
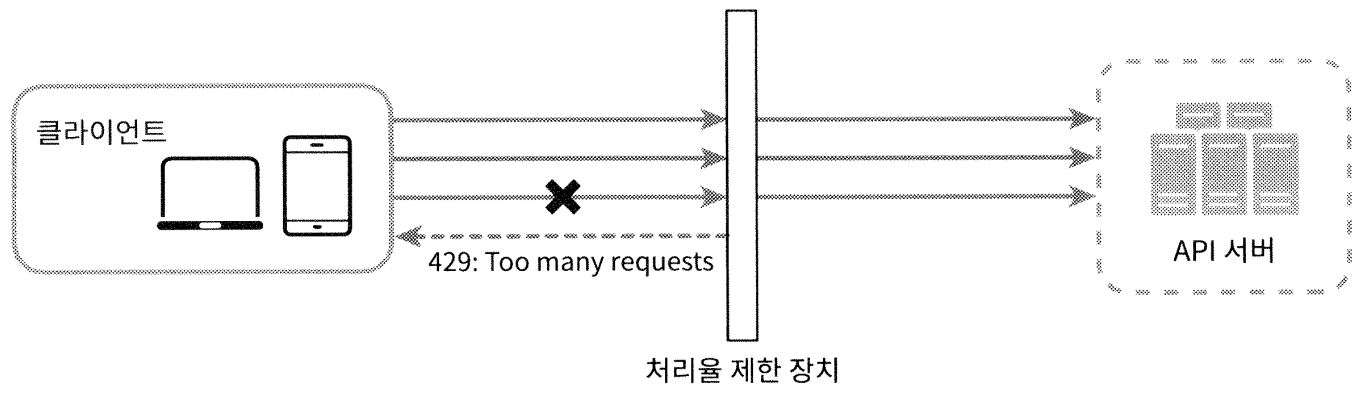
- 미들웨어가 API 서버로 가는 요청을 통제
- 클라우드 마이크로 서비스의 경우 보통 API 게이트웨이라 불리는 컴포넌트에 구현
- API 게이트웨이
- 처리율 제한, SSL 종단(Termination), 사용자 인증(Authentication), 화이트 리스트 관리 등을 지원하는 완전 위탁형 관리 서비스
- 클라우드 업체가 유지 보수를 담당하는 서비스
- API 게이트웨이
- 일반적으로 적용될 수 있는 지침
- 프로그래밍 언어, 캐시 서비스 등 현재 사용하고 있는 기술 스택을 점검
- 사업 필요에 맞는 처리율 제한 알고리즘을 찾기. 서버 측에서 모든 것을 구현하기로 했다면 알고리즘은 자유롭게 선택 가능. 제3사업자가 제공하는 게이트웨이를 사용한다면 선택지는 제한
- 설계가 마이크로서비스에 기반하고 있고, API 게이트웨이를 이미 설계에 포함시켰다면 처리율 제한 기능 또한 게이트웨이에 포함시켜야 할 수도 있음
- 처리율 제한 서비스를 직접 만드는 데는 시간이 듦. 충분한 인력이 없다면 상용 API 게이트웨이를 쓰는 것이 바람직
- 클라이언트
- 처리율 제한 알고리즘
- 토큰 버킷(Token Bucket)
- 처리율 제한에 폭넓게 이용
- 동작 원리
- 토큰 버킷은 지정된 용량을 갖는 컨테이너
- 이 버킷에 사전에 설정된 양의 토큰이 주기적으로 채워짐
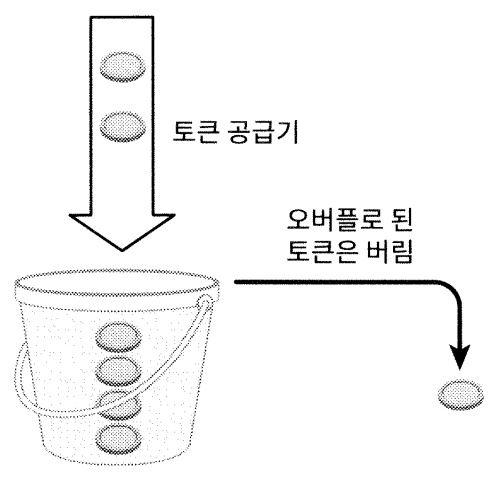
- 각 요청은 처리될 때마다 하나의 토큰을 사용
- 요청이 도착하면 버킷에 충분한 토큰이 있는지 검사
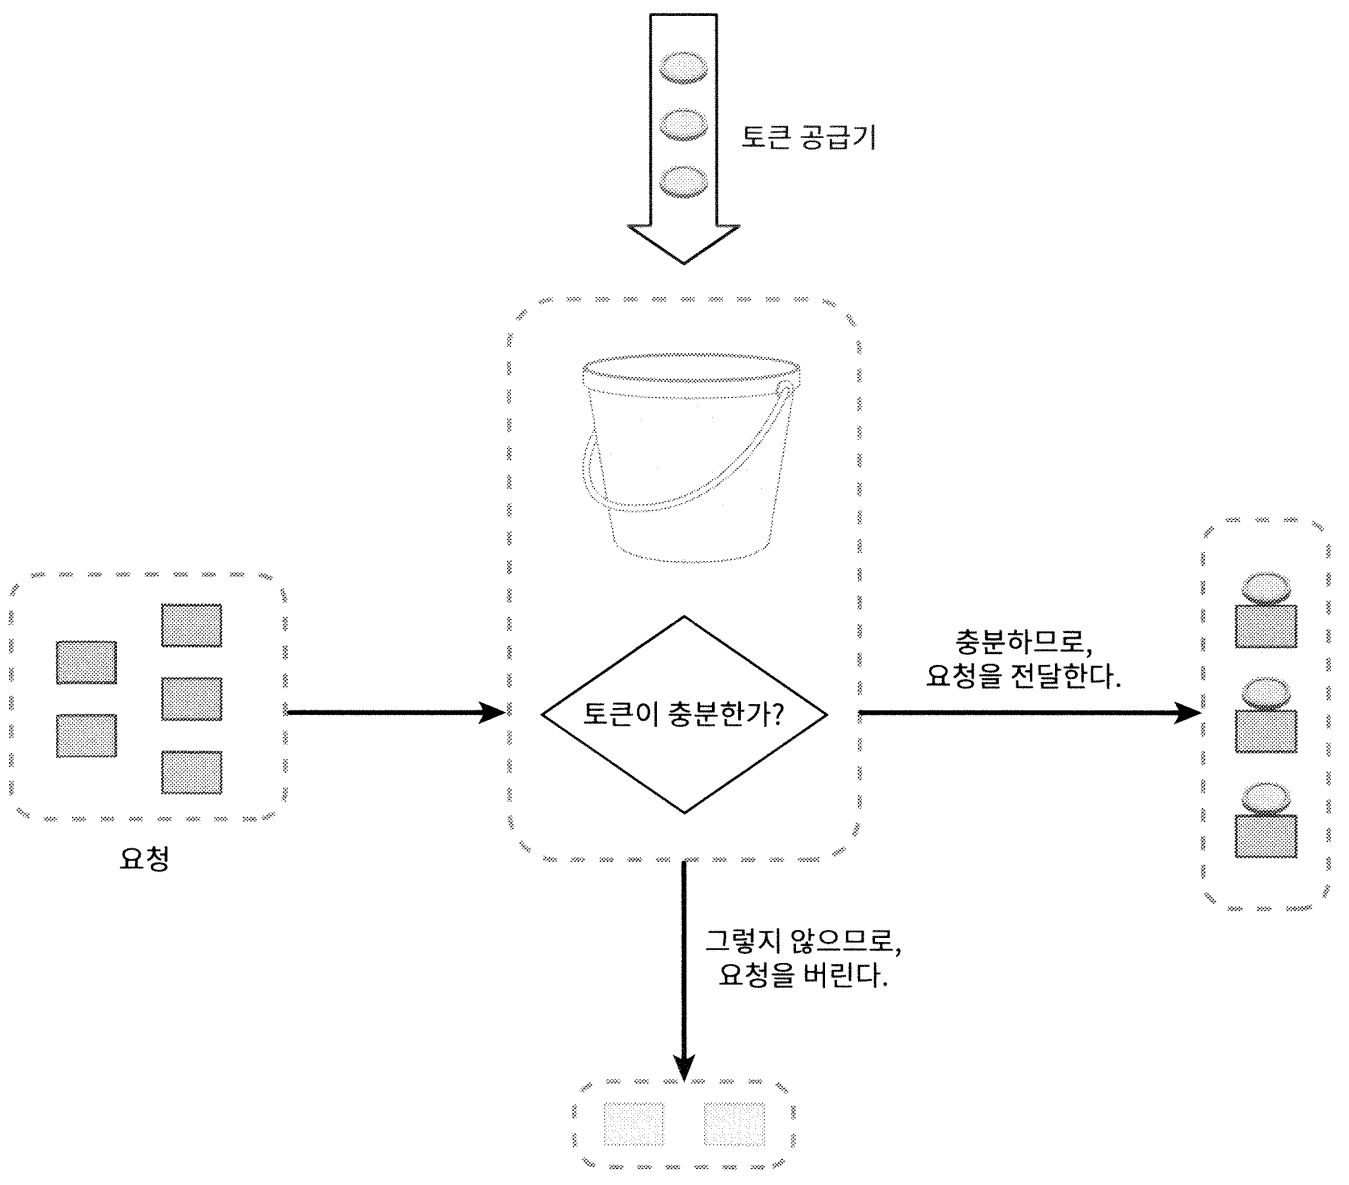
- 충분한 토큰이 있는 경우, 버킷에서 토큰 하나를 꺼낸 후 요청을 시스템에게 전달
- 충분한 토큰이 없는 경우, 해당 요청은 버려짐(Dropped)
- 인자
- 버킷 크기 : 버킷에 담을 수 있는 토큰의 최대 개수
- 토큰 공급률(Refill Rate) : 초당 몇 개의 토큰이 버킷에 공급되는지
- 통상적으로 API 엔드포인트마다 별도의 버킷을 둠
- 사용자마다 하루에 한 번 포스팅을 할 수 있고, 좋아요 버튼은 다섯 번까지만 누를 수 있다면 2개의 버킷이 필요
- IP 주소별로 처리율 제한을 적용해야 한다면 IP 주소마다 버킷을 하나씩 할당해야 함
- 시스템의 처리율을 초당 10000개 요청으로 제한하고 싶다면, 모든 요청이 하나의 버킷을 공유하도록 해야 함
- 장점
- 쉬운 구현
- 효율적인 메모리 사용
- 짧은 시간에 집중되는 트래픽(Burst of Traffic)도 처리 가능
- 단점
- 두 개의 인자를 적절하게 튜닝하는 것이 까다로움
- 누출 버킷(Leaky Bucket)
- 토큰 버킷 알고리즘과 비슷하지만 요청 처리율이 고정되어 있음
- 보통 FIFO 큐로 구현
- 동작 원리
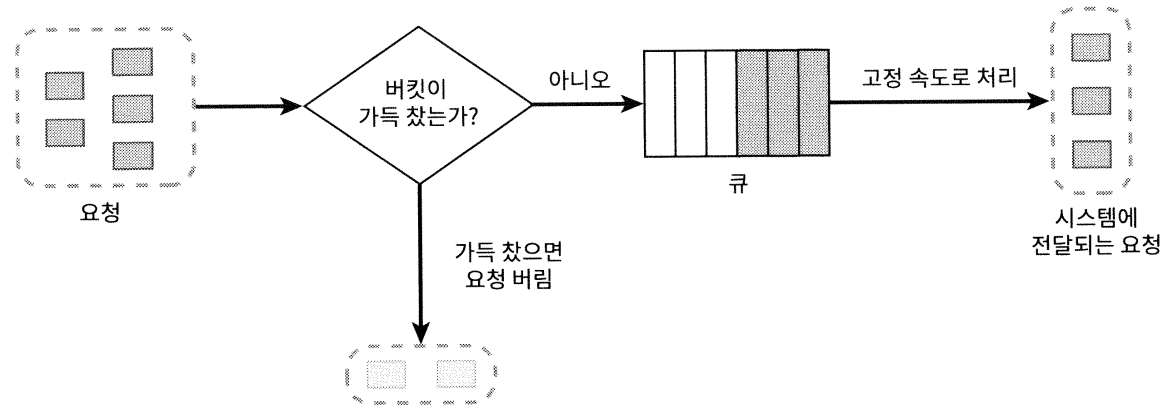
- 요청이 도착하면 큐가 가득 차 있는지 확인. 빈자리가 있는 경우 큐에 요청을 추가
- 큐가 가득 차 있는 경우 새 요청을 버림
- 지정된 시간마다 큐에서 요청을 꺼내어 처리
- 인자
- 버킷 크기 : 큐 사이즈와 같은 값. 큐에는 처리될 항목들이 보관
- 처리율(Outflow Rate) : 지정된 시간당 몇 개의 항목을 처리할지 지정하는 값. 보통 초 단위로 표현
- 장점
- 큐의 크기가 제한되어 있어 메모리 사용량 측면에서 효율적
- 고청된 처리율을 갖기 때문에 안정적 출력(Stable Outflow Rate)이 필요한 경우 적합
- 단점
- 단시간에 많은 트래픽이 몰리는 경우 큐에는 오래된 요청들이 쌓이게 되고, 그 요청들을 제때 처리하지 못하면 최신 요청들은 버려짐
- 두 개의 인자를 적절하게 튜닝하는 것이 까다로울 수 있음
- 고정 윈도우 카운터(Fixed Window Counter)
- 동작 원리
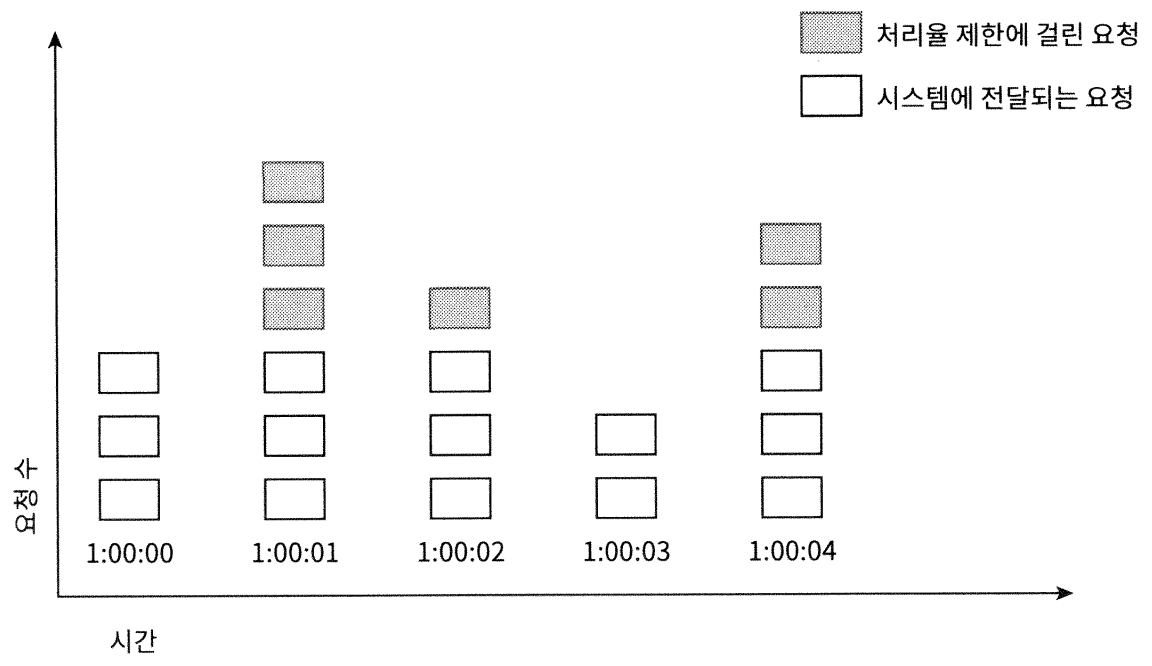
- 타임라인(Timeline)을 고정된 간격의 윈도우로 나누고, 각 윈도우마다 카운터를 붙임
- 요청이 접수될 때마다 카운터의 값이 1씩 증가
- 카운터의 값이 사전에 설정된 임계치에 도달하면 새로운 요청은 새 윈도우가 열릴 때까지 버려짐
- 장점
- 효율적인 메모리 사용
- 이해하기 쉬움
- 윈도우가 닫히는 시점에 카운터를 초기화하는 방식은 특정한 트래픽 패턴을 처리하기 적합
- 단점
- 윈도우 경계 부근에서 일시적으로 많은 트래픽이 몰려드는 경우, 기대했던 시스템의 처리 한도보다 많은 양의 요청을 처리
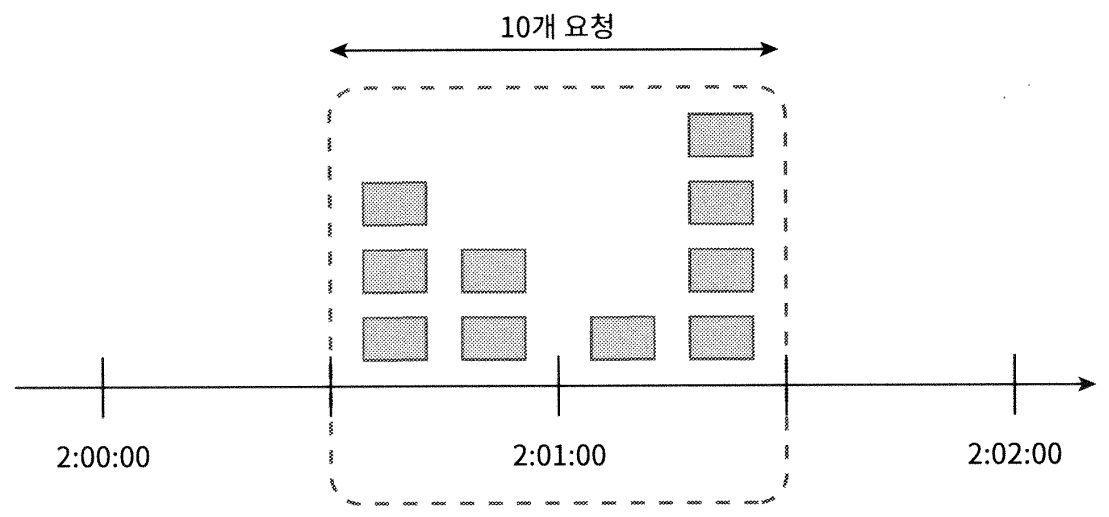
- 분당 최대 5개의 요청을 허용하는 시스템에서, 2:00:30 ~ 2:01:30까지 시스템이 처리한 요청은 10개로, 허용 한계의 2배
- 윈도우 경계 부근에서 일시적으로 많은 트래픽이 몰려드는 경우, 기대했던 시스템의 처리 한도보다 많은 양의 요청을 처리
- 동작 원리
- 이동 윈도우 로그(Sliding Window Log)
- 고정 윈도우 카운터의 문제를 해결
- 동작 원리
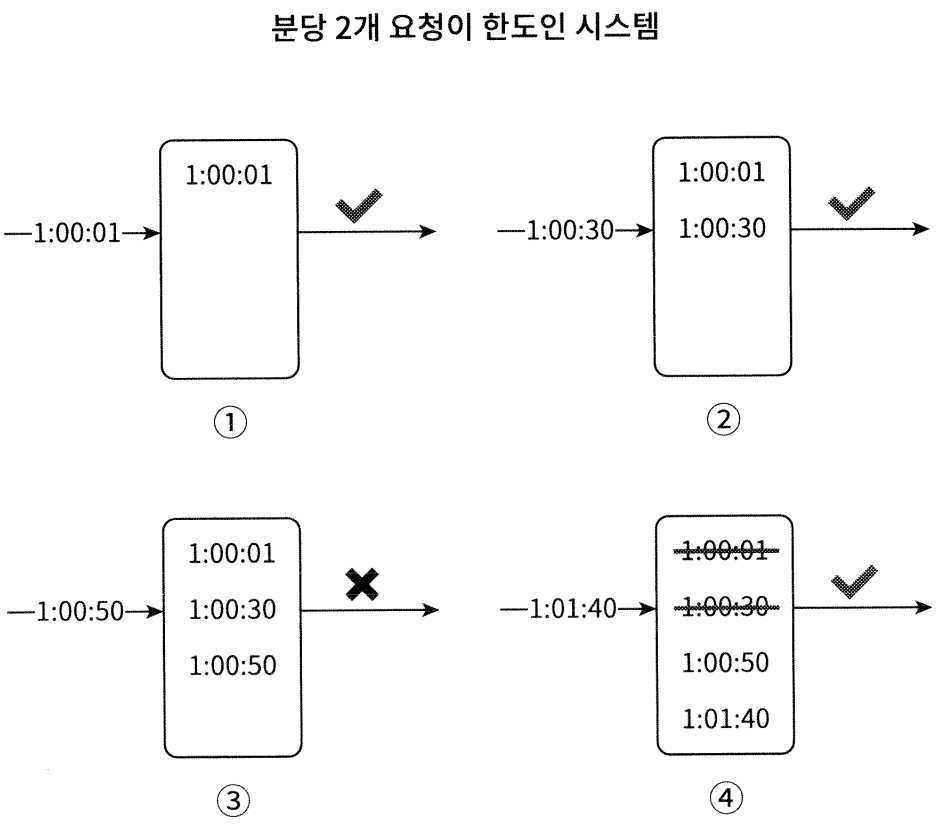
- 타임스탬프(Timestamp)를 추적. 타임스탬프 데이터는 보통 레디스의 정렬 집합(Sorted Set)같은 캐시에 보관
- 새 요청이 오면 만료된 타임스탬프는 제거. 만료된 타임스탬프는 그 값이 현재 윈도우의 시작 시점보다 오래된 타임 스탬프
- 새 요청의 타임스탬프를 로그에 추가
- 로그의 크기가 허용치보다 같거나 작으면 요청을 시스템에 전달. 그렇지 않은 경우 처리를 거부
- 장점
- 처리율 제한 메커니즘은 아주 정교해서 어느 순간의 윈도우를 보더라도 허용되는 요청의 개수는 시스템의 처리율 한도를 넘지 않음
- 단점
- 거부된 요청의 타임스탬프도 보관하기 때문에 다량의 메모리 사용
- 이동 윈도우 카운터(Sliding Window Counter)
- 고정 윈도우 카운터 알고리즘과 이동 윈도우 로그 알고리즘을 결합
- 구현하는데 두 가지 접근법이 사용될 수 있음
- 동작 원리
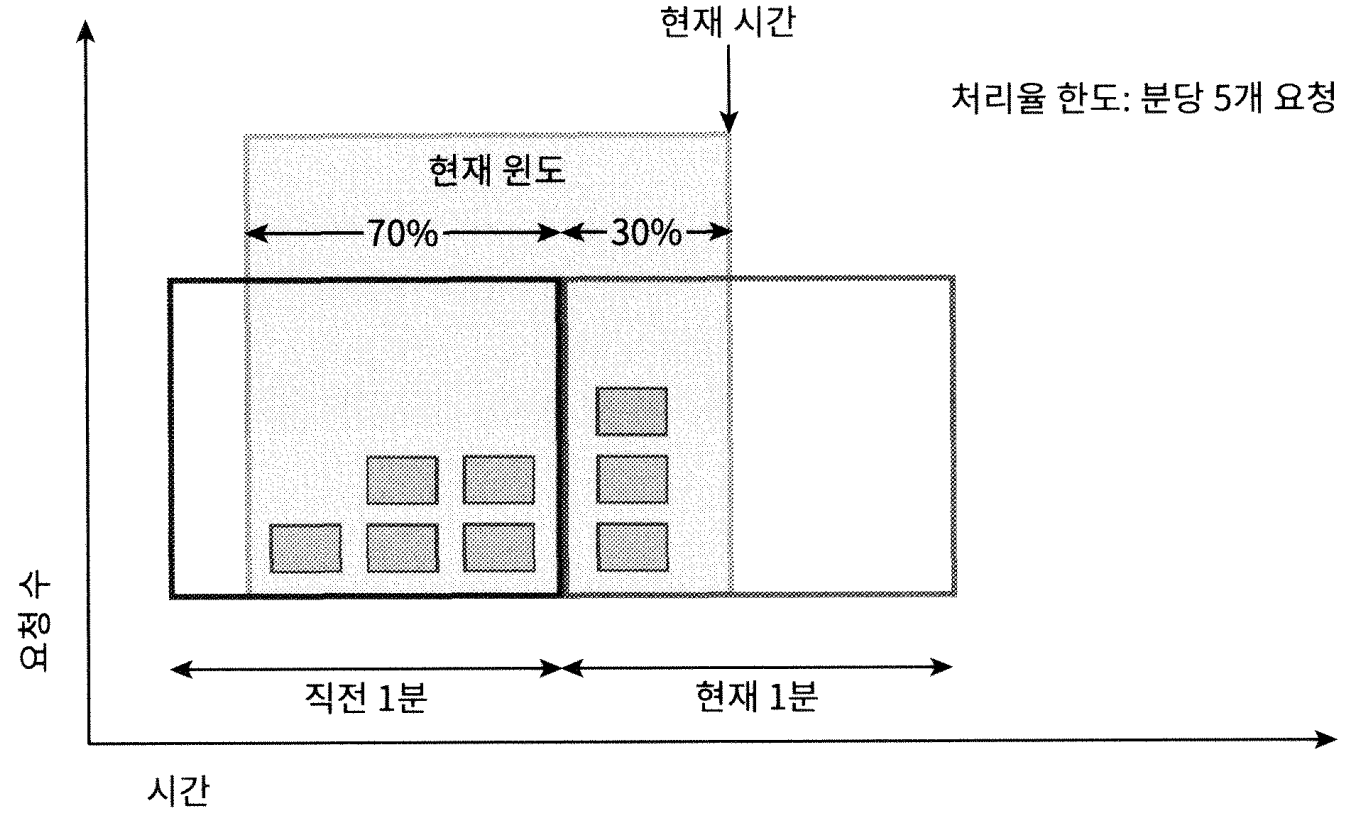
- 현재 1분간 요청의 수 + 직전 1분간의 요청 수 * 이동 윈도우와 직전 1분이 겹치는 비율
- 3 + 5 * 70% = 6.5개
- 반올림하거나 내림하여 쓸 수 있음
- 내림으로 가정하고, 현재 윈도우에 6개의 요청이 온 것으로 가정
- 분당 5개의 요청을 처리할 수 있으므로 1개의 요청은 무시
- 장점
- 이전 시간대의 평균 처리율에 따라 현재 윈도우의 상태를 계산하므로 짧은 시간에 몰리는 트래픽에도 잘 대응
- 효율적인 메모리 사용
- 단점
- 직전 시간대에 도착한 요청이 균등하게 분포되어 있다고 가정한 상태에서 추정치를 계산하기 때문에 다소 느슨함
- 큰 단점은 아님 → 클라우드플레어가 실시했던 실험에 따르면 40억 개의 요청 가운데 시스템의 실제 상태와 맞지 않게 허용되거나 버려진 요청은 0.003%에 불과함
- 토큰 버킷(Token Bucket)
- 개략적인 아키텍처
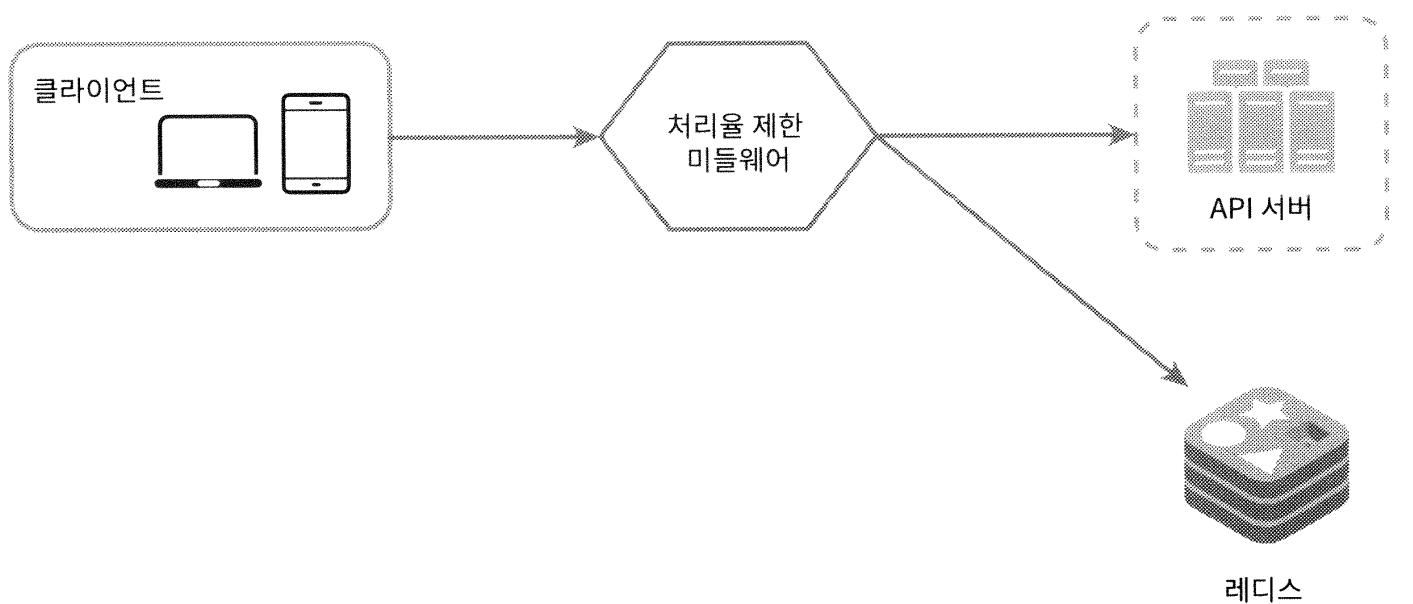
- 카운터는 메모리 상에서 동작하는 캐시가 바람직
- 빠르고, 시간에 기반한 만료 정책을 지원하기 때문
- 동작 원리
- 클라이언트가 처리율 제한 미들웨어에게 요청을 보냄
- 처리율 제한 미들웨어는 레디스의 지정 버킷에서 카운터를 가져와서 한도에 도달했는지 아닌지 검사
- 한도에 도달했다면 요청 거부
- 한도에 도달하지 않았다면 요청은 API 서버로 전달하고, 미들웨어는 카운터의 값을 증가시킨 후 다시 레디스에 저장
- 카운터는 메모리 상에서 동작하는 캐시가 바람직
- 처리율 제한 장치는 어디에 둘 것인가?
-
상세 설계
- 처리율 제한 규칙
- 보통 설정 파일(Configuration File) 형태로 디스크에 저장
- 처리율 한도 초과 트래픽의 처리
- 처리율 제한 장치가 사용하는 HTTP 헤더
- X-Ratelimit-Remaining
- 윈도우 내에 남은 처리 가능 요청의 수
- X-Ratelimit-Limit
- 매 윈도우마다 클라이언트가 전송할 수 있는 요청의 수
- X-Ratelimit-Retry-After
- 한도 제한에 걸리지 않으려면 몇 초 뒤 요청을 다시 보내야 하는지 알람
- 사용자가 너무 많은 요청을 보내면 429 too many requests 오류를 X-Ratelimit-Retry-After 헤더와 함께 반환
- X-Ratelimit-Remaining
- 상세 설계
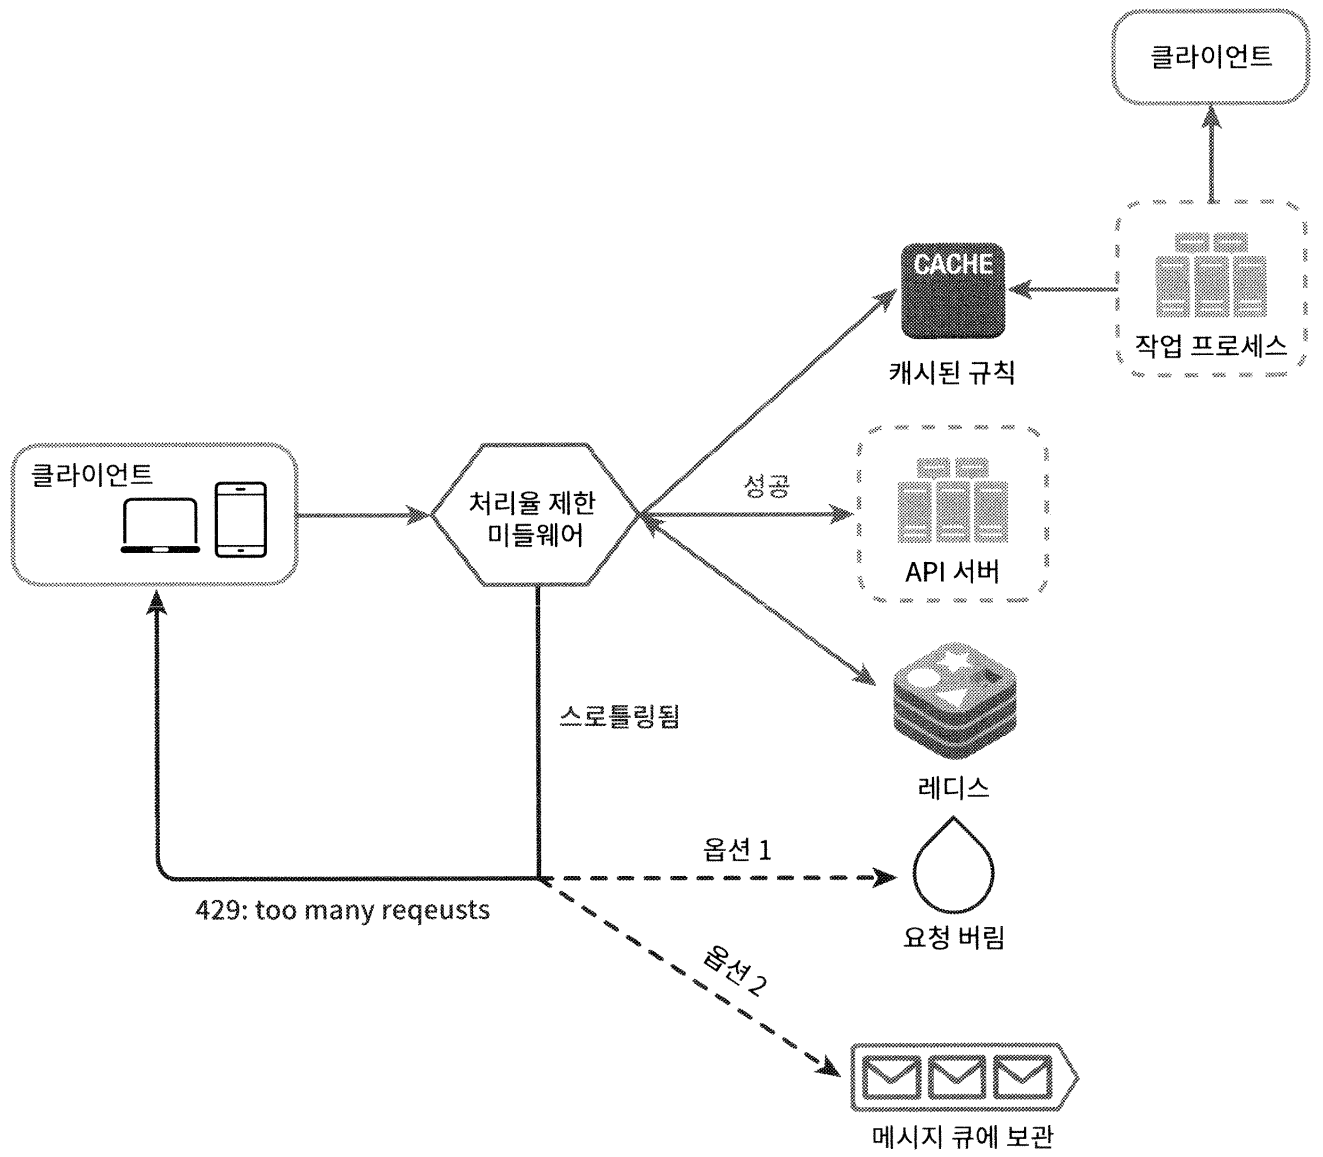
- 처리율 제한 규칙은 디스크에 보관. 작업 프로세스(Workers)는 수시로 규칙을 디스크에서 읽어 캐시에 저장
- 클라이언트가 요청을 서버에 보내면 요청은 먼저 처리율 제한 미들웨어에 도달
- 처리율 제한 미들웨어는 제한 규칙을 캐시에서 가져오고, 카운터 및 마지막 요청의 타임스탬프를 레디스 캐시에서 가져옴. 가져온 값들에 근거하여 미들웨어는 결정을 내림
- 해당 요청이 처리율 제한에 걸리지 않은 경우 API 서버로 보냄
- 해당 요청이 처리율 제한에 걸렸다면 429 too many requests 에러를 클라이언트에 전송. 해당 요청은 버릴 수도 있고, 메시지 큐에 보관할 수도 있음
- 처리율 제한 장치가 사용하는 HTTP 헤더
- 분산 환경에서의 처리율 제한 장치의 구현
- 경쟁 조건(Race Condition)
- 병행성이 심한 환경에서는 경쟁 조건 이슈가 발생할 수 있음
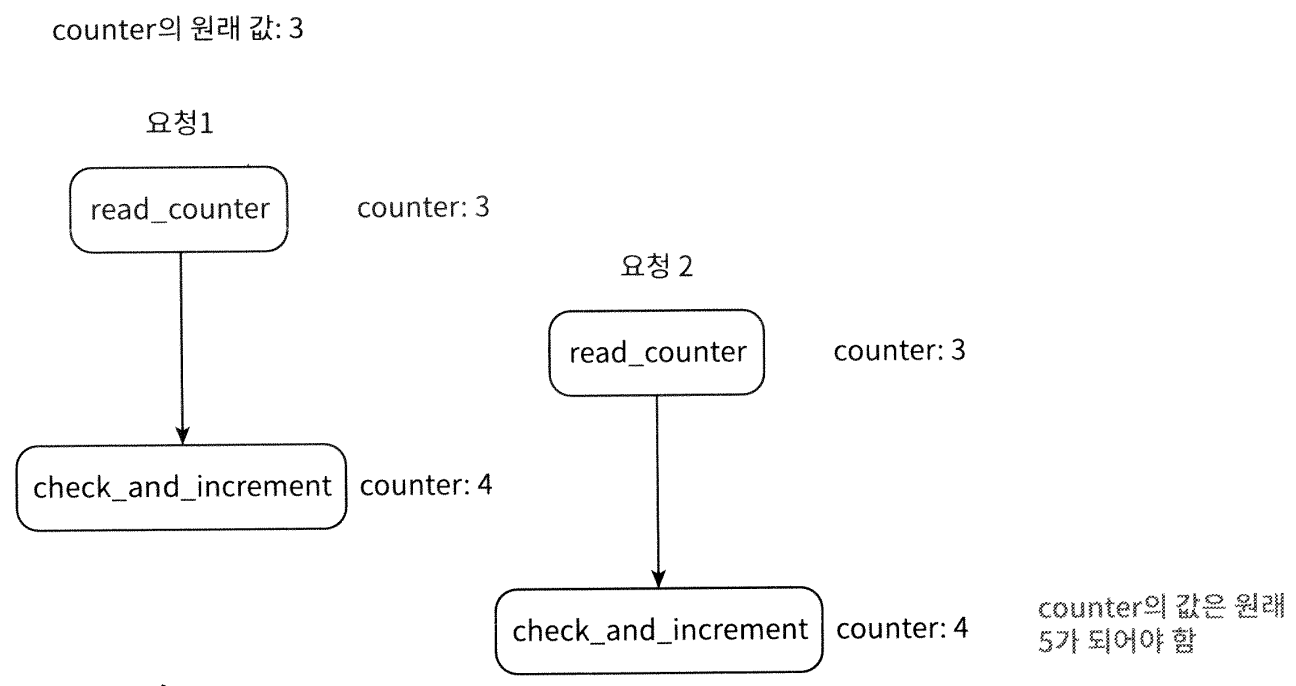
- 락 대신 사용할 해결책
- 병행성이 심한 환경에서는 경쟁 조건 이슈가 발생할 수 있음
- 동기화 이슈
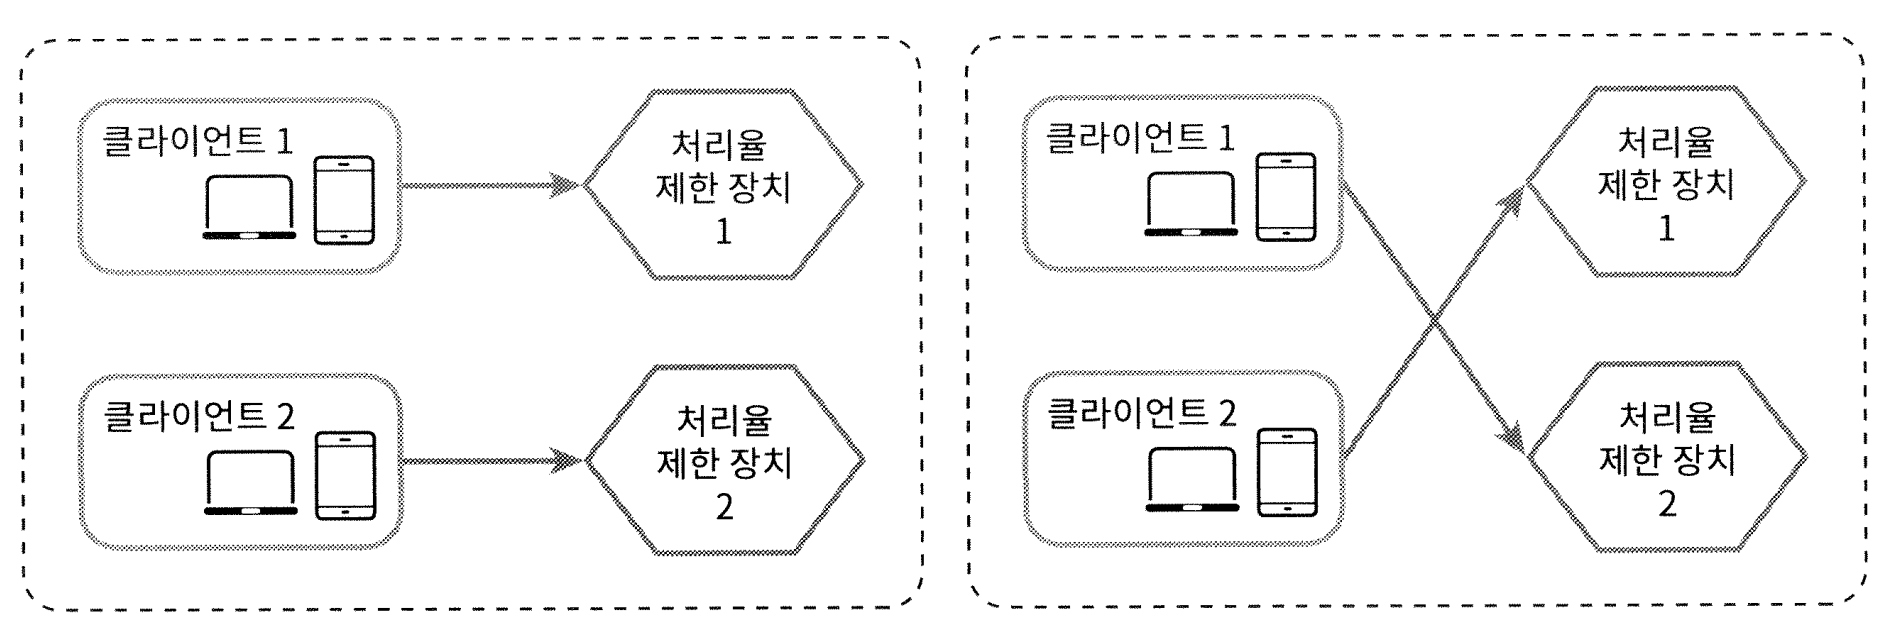
- 처리율 제한 장치 서버를 여러 대 두게 되면 동기화가 필요해짐
- 고정 세션(Sticky Session)을 활용하여 같은 클라이언트로부터의 요청은 항상 같은 처리율 제한 장치로 보낼 수 있도록 하기 → 규모면에서 확장 가능하지도 않고, 유연하지도 않기 때문에 비추천
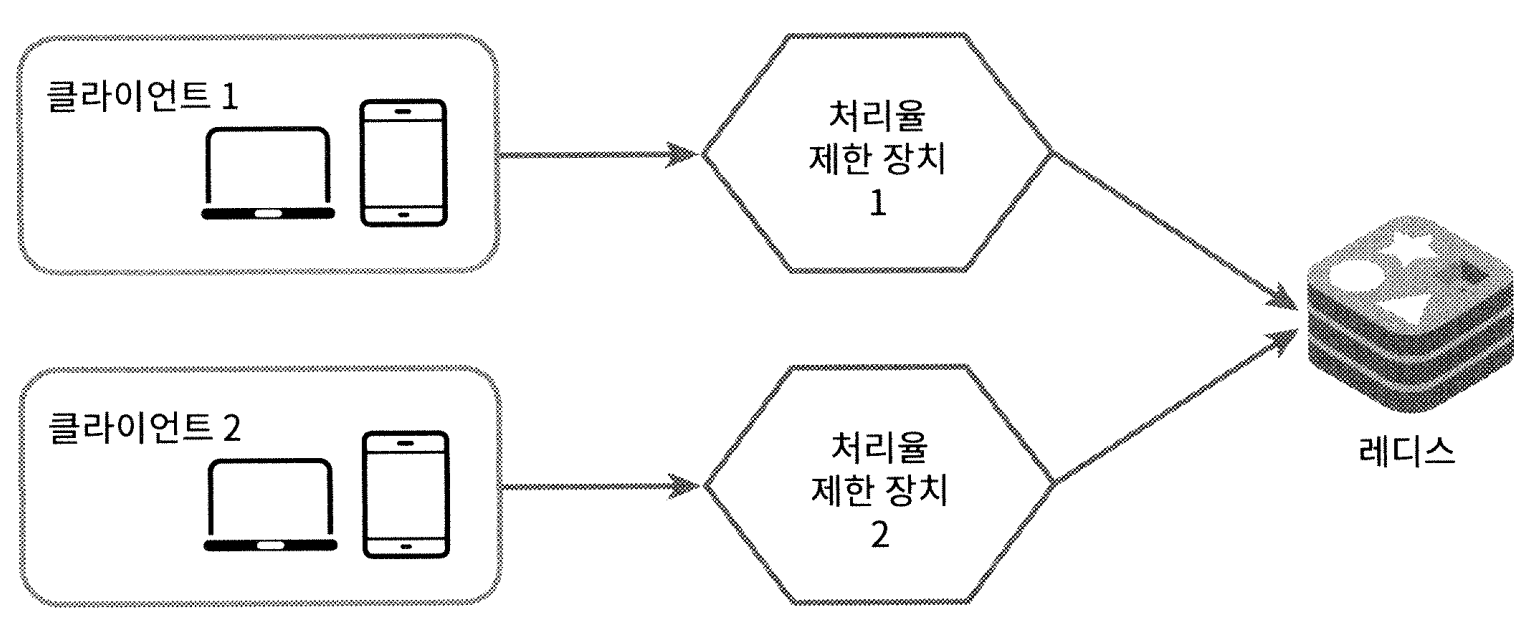
- 레디스와 같은 중앙 집중형 데이터 저장소를 사용
- 성능 최적화
- 여러 데이터센터를 지원하는 문제는 처리율 제한 장치에 매우 중요한 문제
- 대부분의 클라우드 서비스 사업자는 세계 곳곳에 에지 서버(Edge Server)를 심어놓고 있음
- 사용자의 트래픽을 가장 가까운 에지 서버로 전달하여 지연시간을 줄임
- 제한 장치 간에 데이터를 동기화할 때 최종 일관성 모델(Eventual Consistency Model)을 사용
- 모니터링
- 채택한 처리율 제한 알고리즘이 효과적인지, 정의한 처리율 제한 규칙이 효과적인지 확인 필요
- 경쟁 조건(Race Condition)
- 처리율 제한 규칙
-
마무리
- 경성(Hard) 또는 연성(Soft) 처리율 제한
- 경성 처리율 제한 : 요청의 개수는 임계치를 절대 넘어설 수 없다
- 연성 처리율 제한 : 요청의 개수는 잠시 동안 임계치를 넘어설 수 있다
- 다양한 계층에서의 처리율 제한
- Iptables를 사용하면 IP 주소에 처리율 제한을 적용 가능
- 처리율 제한을 회피하는 방법. 클라이언트를 어떻게 설계하는 것이 최선인가?
- 클라이언트 측 캐시를 사용하여 API 호출 횟수를 줄임
- 처리율 제한의 임계치를 이해하고, 짧은 시간 동안 너무 많은 메시지를 보내지 않도록 하기
- 예외나 에러를 처리하는 코드를 도입하여 클라이언트가 예외적 상황으로부터 우아하게 복구될 수 있도록 함
- 재시도(Retry) 로직을 구현할 때는 충분한 백오프(Back-Off) 시간을 두기
- 경성(Hard) 또는 연성(Soft) 처리율 제한