가상 면접 사례로 배우는 대규모 시스템 설계 기초 - 9장
9. 웹 크롤러 설계
- 크롤러의 이용
- 검색 엔진 인덱싱
- 크롤러의 가장 보편적인 용례
- 웹 페이지를 모아 검색 엔진을 위한 로컬 인덱스를 생성
- 웹 아카이빙
- 나중에 사용할 목적으로 장기보관하기 위해 웹에서 정보를 모으는 절차
- 웹 마이닝
- 웹의 인터넷에서 유용한 지식을 도출
- 웹 모니터링
- 인터넷에서 저작권이나 상표권이 침해되는 사례를 모니터링 할 수 있음
- 검색 엔진 인덱싱
- 문제 이해 및 설계 범위 확정
- 기본 알고리즘
- URL 집합이 입력으로 주어지면, 해당 URL들이 가리키는 모든 웹 페이지를 다운로드
- 다운받은 웹 페이지에서 URL들을 추출
- 추출된 URL들을 다운로드할 URL 목록에 추가하고 위의 과정을 처음부터 반복
- 웹 크롤러가 만족시켜야 할 속성
- 규모 확장성
- 웹에는 수십억 개의 페이지가 존재
- 병행성(Parallelism)을 활용하면 보다 효과적으로 웹 크롤링 가능
- 안정성(Robustness)
- 잘못 작성된 HTML, 아무 반응이 없는 서버, 장애, 악성 코드가 붙어 있는 링크 등
- 비정상적 입력이나 환경에 잘 대응할 수 있어야 함
- 예절(Politeness)
- 수집 대상 웹 사이트에 짧은 시간 동안 너무 많은 요청을 보내서는 안됨
- 확장성(Extensibility)
- 새로운 형태의 콘텐츠를 지원하기가 쉬워야 함
- 규모 확장성
- 기본 알고리즘
- 개략적 설계안 제시 및 동의 구하기
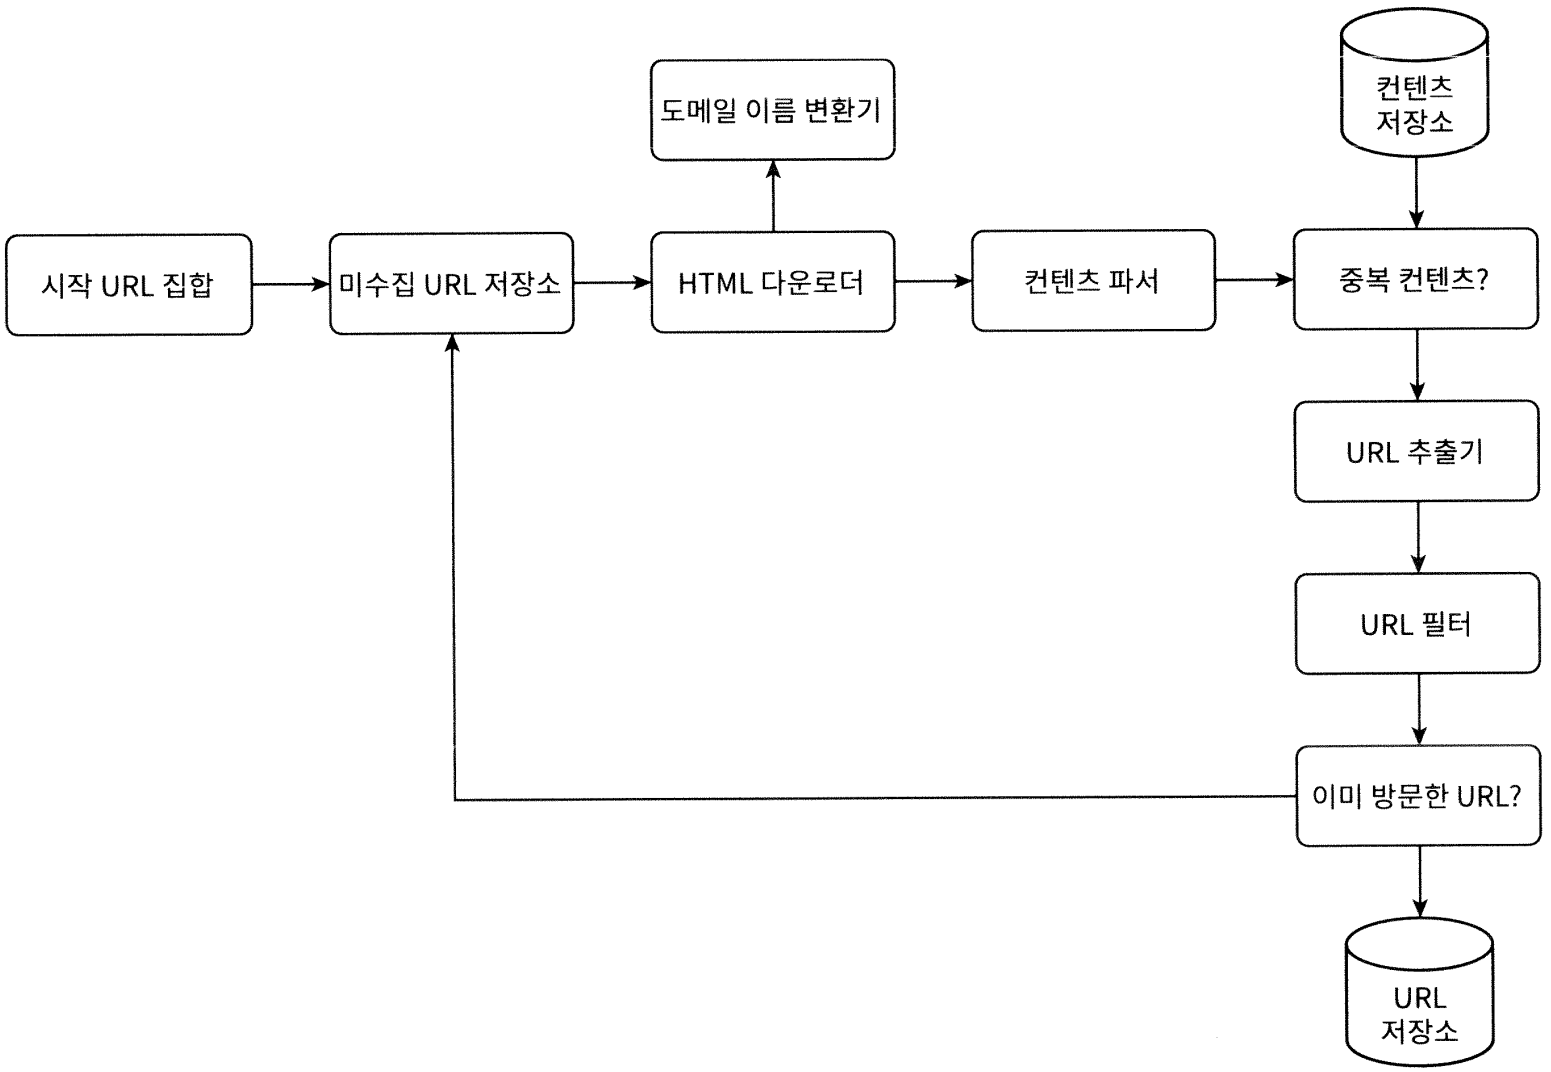
- 시작 URL집합
- 웹 크롤러가 크롤링을 시작하는 출발점
- 예를 들어, 어떤 대학 웹사이트로부터 찾아 나갈 수 있는 모든 웹 페이지를 크롤링하는 가장 직관적인 방법은 해당 대학의 도메인 이름이 붙은 모든 페이지의 URL을 시작 URL로 사용하는 것
- 크롤러가 가능한 한 많은 링크를 탐색할 수 있도록 하는 URL을 고르는 것이 바람직
- 일반적으로는 전체 URL 공간을 작은 부분집합으로 나누는 전략을 사용
- 주제별로 다른 시작 URL을 사용
- 미수집 URL 저장소
- 현대적 웹 크롤러는 상태를 다운로드할 URL, 다운로드된 URL의 두 가지로 나누어 관리
- 다운로드할 URL을 저장 관리하는 컴포넌트를 미수집 URL 저장소(URL Frontier)라고 부름
- HTML 다운로더
- 웹 페이지를 다운로드하는 컴포넌트
- 다운로드할 페이지의 URL은 미수집 URL 저장소가 제공
- 도메인 이름 변환기
- URL을 IP 주소로 변환하는 절차가 필요
- HTML 다운로더는 도메인 이름 변환기를 사용하여 URL에 대응되는 IP 주소를 알아냄
- 콘텐츠 파서
- 웹 페이지를 다운로드하면 파싱(Parsing)과 검증(Validation) 절차를 거쳐야 함
- 이상한 웹 페이지는 문제를 일으킬 수 있는데다 저장 공간만 낭비
- 크롤링 서버 안에 콘텐츠 파서를 구현하면 크롤링 과정이 느려지게 될 수 있으므로, 독립적인 컴포넌트로 제작
- 중복 콘텐츠인가?
- 29% 가량의 웹 페이지 콘텐츠는 중복
- 이미 시스템에 저장된 콘텐츠임을 알아내기 쉽게 하는 자료 구조를 도입하여 데이터 중복을 줄이고, 데이터 처리에 소요되는 시간을 줄임
- 두 HTML 문서를 비교하는 가장 간단한 방법은 두 문서를 문자열로 보고 비교하는 것 → 비교 대상 문서의 수가 10억에 달하는 경우에는 느리고 비효율적
- 효과적인 방법은 웹 페이지의 해시 값을 비교하는 것
- 콘텐츠 저장소
- HTML 문서를 보관하는 시스템
- 저장소를 구현하는 데 쓰일 기술을 고를 때는 저장할 데이터의 유형, 크기, 저장소 접근 빈도, 데이터의 유효 기간 등을 종합적으로 고려해야 함
- URL 추출기
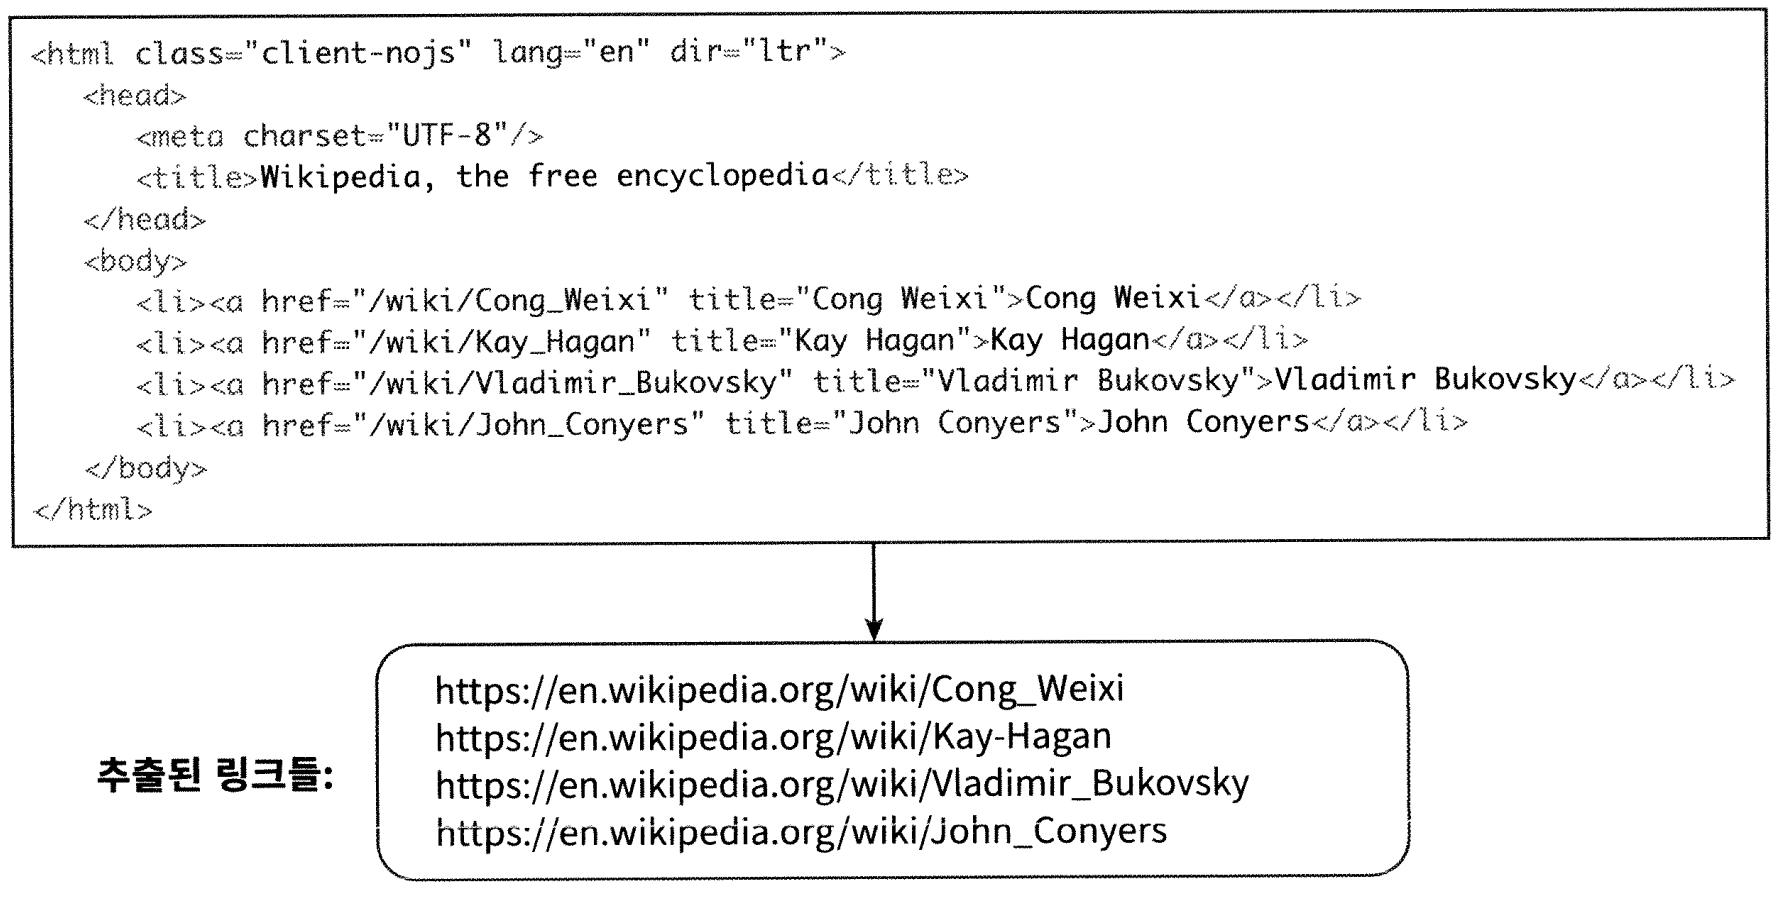
- URL 추출기는 HTML 페이지를 파싱하여 링크들을 골라내는 역할을 함
- 상대경로는 전부 링크를 붙여 절대 경로로 변환
- URL 필터
- 특정한 콘텐츠 타입이나 파일 확장자를 갖는 URL, 접속시 오류가 발생하는 URL, 접근 제외 목록(Deny List)에 포함된 URL 등을 크롤링 대상에서 배제
- 이미 방문한 URL
- 이미 방문한 URL이나 미수집 URL 저장소에 보관된 URL을 추적할 수 있도록 하는 자료 구조를 사용
- 같은 URL을 여러 번 처리하는 일을 방지할 수 있으므로 서버 부하를 줄이고 시스템이 무한 루프에 빠지는 일을 방지
- 블룸 필터(Bloom Filter)나 해시 테이블이 사용
- URL 저장소
- 이미 방문한 URL을 보관하는 저장소
- 웹 크롤러 작업 흐름
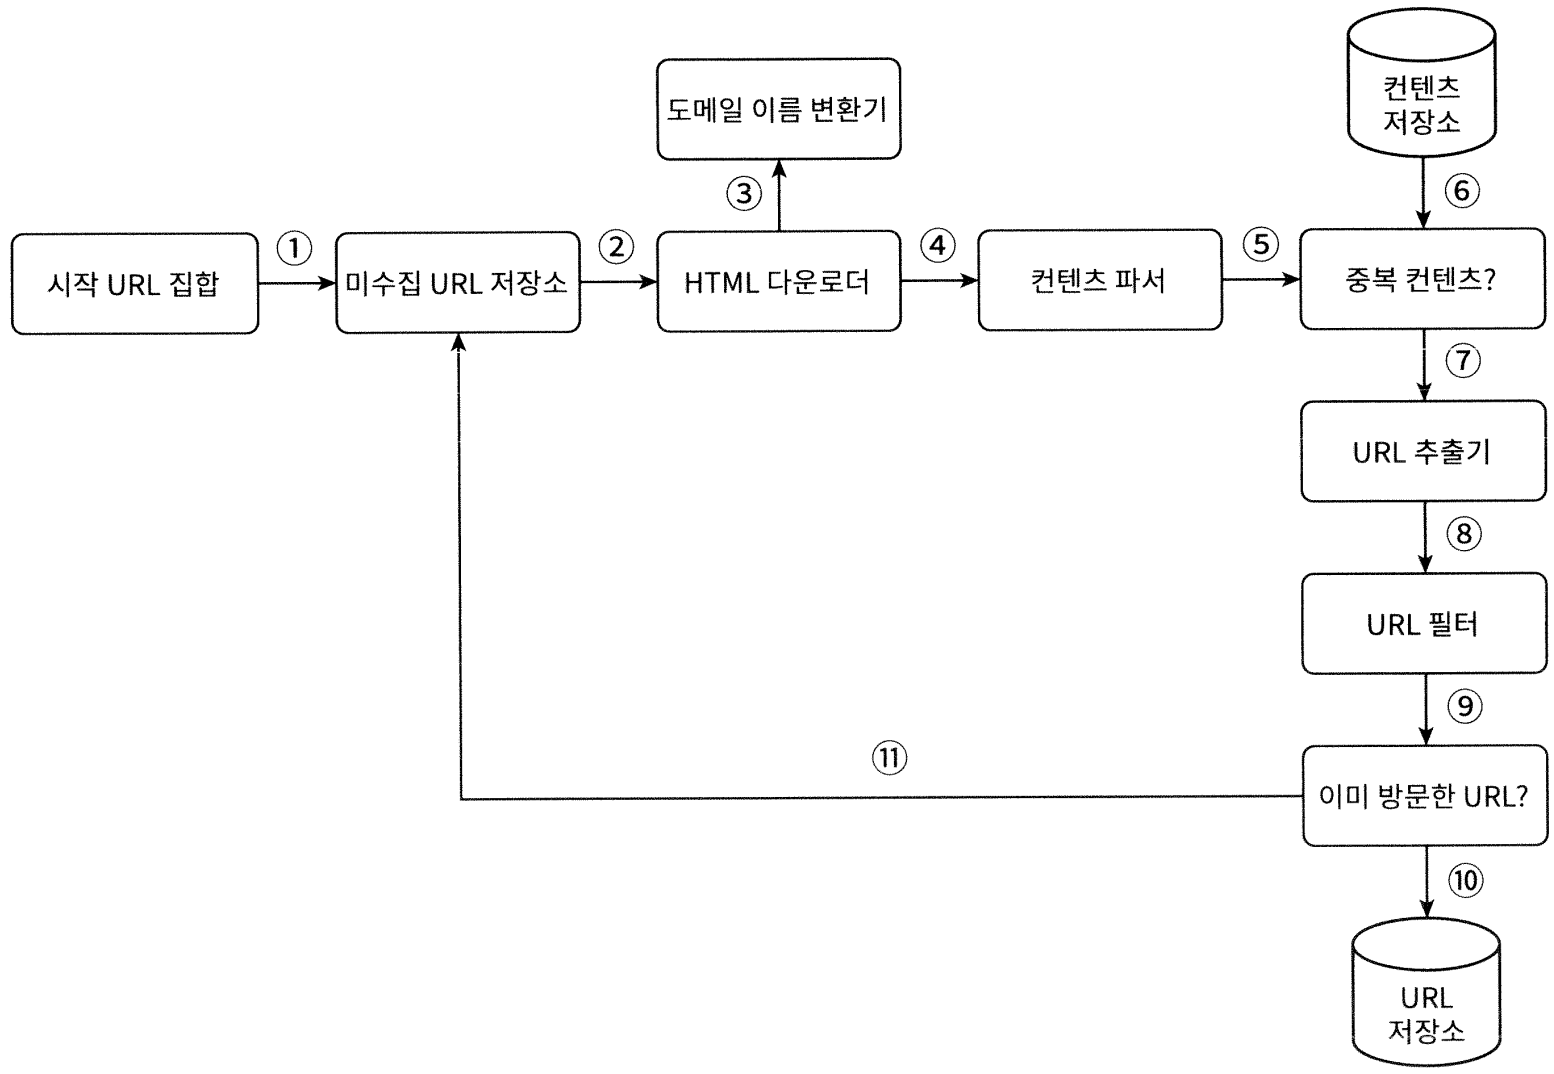
- 시작 URL들을 미수집 URL 저장소에 저장
- HTML 다운로더는 미수집 URL 저장소에서 URL 목록을 가져옴
- HTML 다운로더는 도메인 이름 변환기를 사용하여 URL의 IP 주소를 알아내고, 해당 IP 주소로 접속하여 웹 페이지를 다운
- 콘텐츠 파서는 다운된 HTML 페이지를 파싱하여 올바른 형식을 갖춘 페이지인지 검증
- 콘텐츠 파싱과 검증이 끝나면 중복 콘텐츠인지 확인하는 절차를 개시
- 중복 콘텐츠인지 확인하기 위해, 해당 페이지가 이미 저장소에 있는지 확인
- 이미 저장소에 있는 콘텐츠인 경우 처리하지 않고 버림
- 저장소에 없는 콘텐츠인 경우 저장소에 저장한 뒤 URL 추출기로 전달
- URL 추출기는 해당 HTML 페이지에서 링크를 골라냄
- 골라낸 링크를 URL 필터로 전달
- 필터링이 끝나고 남은 URL만 중복 URL 판별 단계로 전달
- 이미 처리할 URL인지 확인하기 위해, URL 저장소에 보관된 URL인지 확인. 이미 저장소에 있는 URL은 버림
- 저장소에 없는 URL은 URL 저장소에 저장할 뿐 아니라 미수집 URL 저장소에도 전달
- 시작 URL집합
- 상세 설계
- DFS를 쓸 것인가, BFS를 쓸 것인가
- 웹은 유향 그래프와 같음
- 페이지는 노드이고, 하이퍼링크는 에지
- 크롤링 프로세스는 이 유향 그래프를 에지를 따라 탐색하는 과정
- DFS는 좋은 선택이 아닐 가능성이 높음
- 그래프 크기가 클 경우 어느 정도로 깊숙이 가게 될지 가늠하기 어렵기 때문
- 보통 BFS를 사용
- 두 가지 문제점이 있음
- 한 페이지에서 나오는 링크의 상당 수는 같은 서버로 되돌아 감
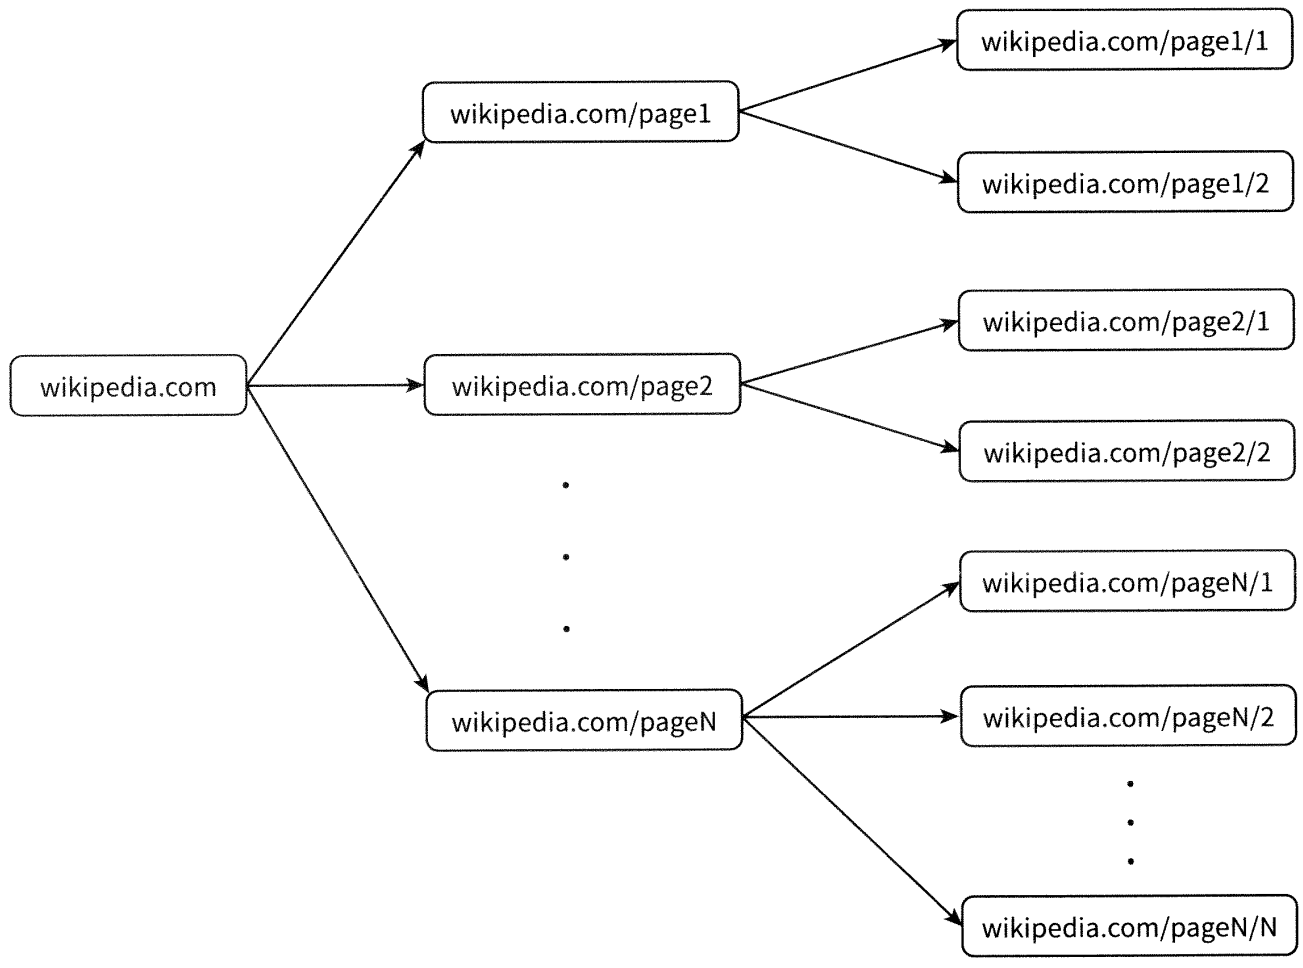
wekipedia.com페이지에서 추출한 모드 링크는 내부 링크, 즉 동일한wikipedia.com서버의 다른 페이지를 참조하는 링크- 크롤러는 같은 호스트에 속한 많은 링크를 다운받느라 바빠지는데, 이 링크들을 병렬로 처리하게 되면 위키피디아 서버는 수많은 요청으로 과부하게 걸릴 것
- 이런 크롤러는 보통 예의 없는(Impolite) 크롤러로 간주
- 표준적 BFS 알고리즘은 URL 간에 우선순위를 두지 않음
- 모든 웹 페이지가 같은 수준의 품질, 같은 수준의 중요성을 갖지 않음
- 페이지 순위(Page Rank), 사용자 트래픽의 양, 업데이트 빈도 등 여러 가지 척도에 비추어 처리 우선순위를 구별하는 것이 온당함
- 한 페이지에서 나오는 링크의 상당 수는 같은 서버로 되돌아 감
- 두 가지 문제점이 있음
- 웹은 유향 그래프와 같음
- 미수집 URL 저장소
- 이 저장소를 잘 구현하면 예의를 갖춘 크롤러, URL 사이의 우선순위와 신선도(Freshness)를 구별하는 크롤러를 구현할 수 있음
- 예의
- 웹 크롤러는 수집 대상 서버로 짧은 시간 안에 너무 많은 요청을 보내는 것을 삼가야 함
- 너무 많은 요청은 무례한 일이며, 때로는 Dos 공격으로 간주
- 예의 바른 크롤러를 만드는 데 있어서 지켜야 할 한 가지 원칙은, 동일 웹 사이트에 대해서는 한 번에 한 페이지만 요청한다는 것
- 같은 웹 사이트의 페이지를 다운받는 태스크는 시간차를 두고 실행
- 이 요구사항을 만족시키려면 웹 사이트의 호스트명(Hostname)과 다운로드를 수행하는 작업 스레드(Worker Thread) 사이의 관계를 유지하면 됨
- 즉, 각 다운로드 스레드는 별도 FIFO 큐를 가지고 있어서, 해당 큐에서 꺼낸 URL만 다운로드 함
- 설계
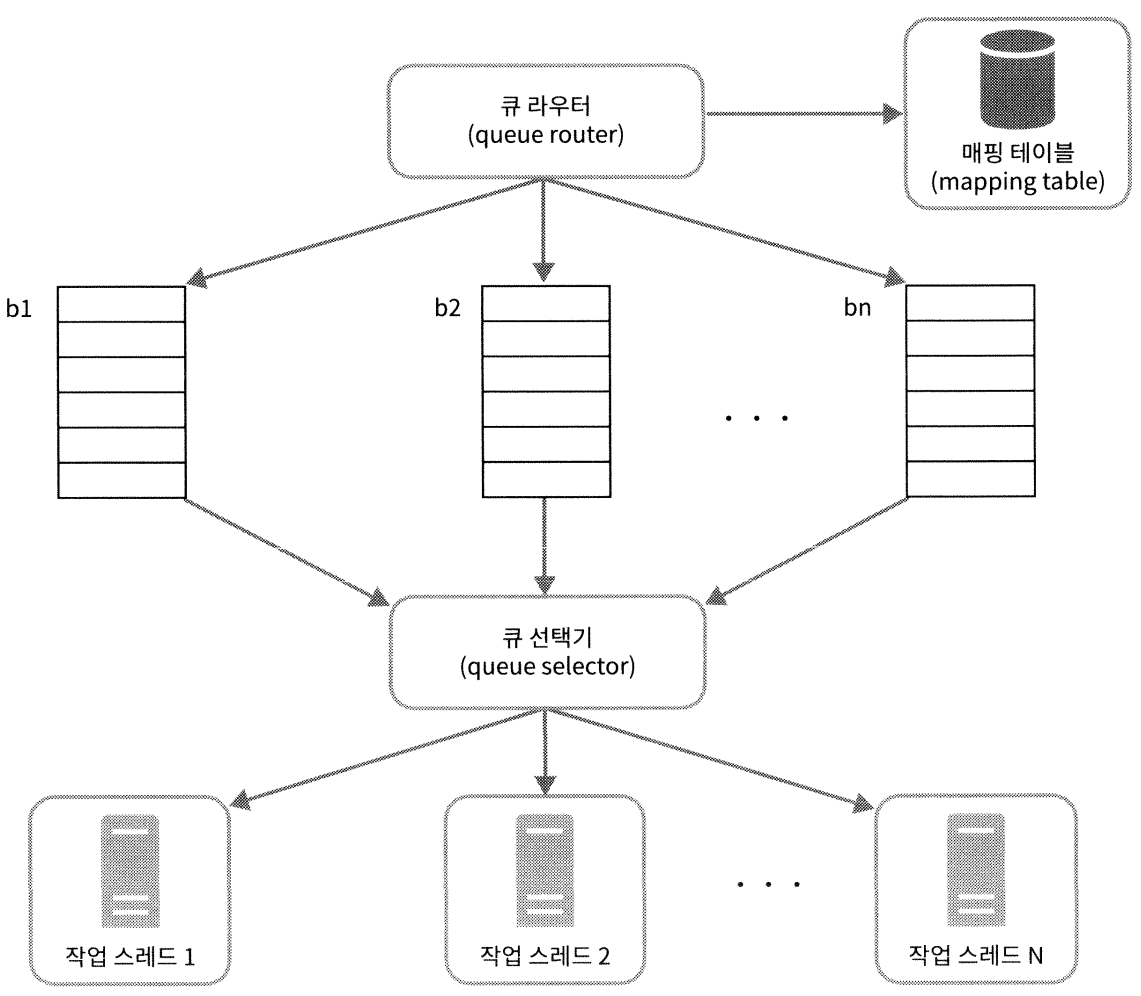
- 큐 라우터(Queue Router)
- 같은 호스트에 속한 URL은 언제나 같은 큐로 가도록 보장하는 역할
- 매핑 테이블(Mapping Table)
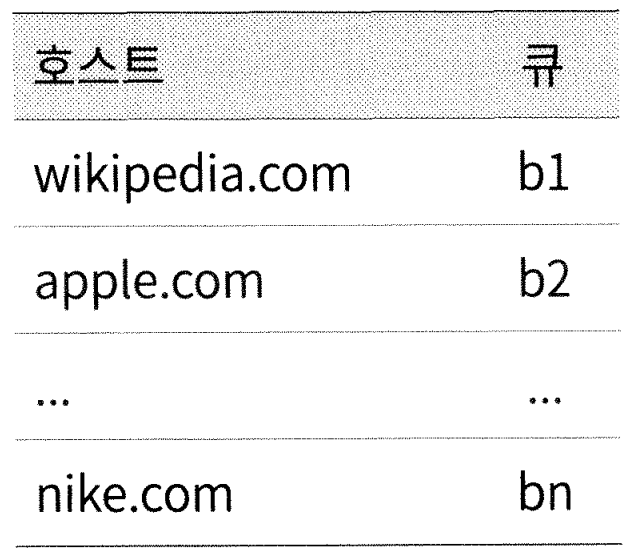
- 호스트 이름과 큐 사이의 관계를 보관하는 테이블
- FIFO 큐
- 같은 호스트에 속한 URL은 언제나 같은 큐에 보관
- 큐 선택기(Queue Selector)
- 큐 선택기는 큐들을 순회하면서 큐에서 URL을 꺼내서 해당 큐에서 나온 URL을 다운로드하도록 지정된 작업 스레드에 전달하는 역할
- 작업 스레드(Worker Thread)
- 전달된 URL을 다운로드하는 작업을 수행
- 순차적으로 처리
- 작업들 사이에 일정한 지연시간(Delay)을 둘 수 있음
- 큐 라우터(Queue Router)
- 우선순위
- 유용성에 따라 URL의 우선순위를 나눌 때는 페이지랭크(PageRank), 트래픽 양, 갱신 빈도(Update Frequency) 등 다양한 척도를 사용
- 순위결정장치(Prioritizer)는 URL 우선순위를 정하는 컴포넌트
- 설계
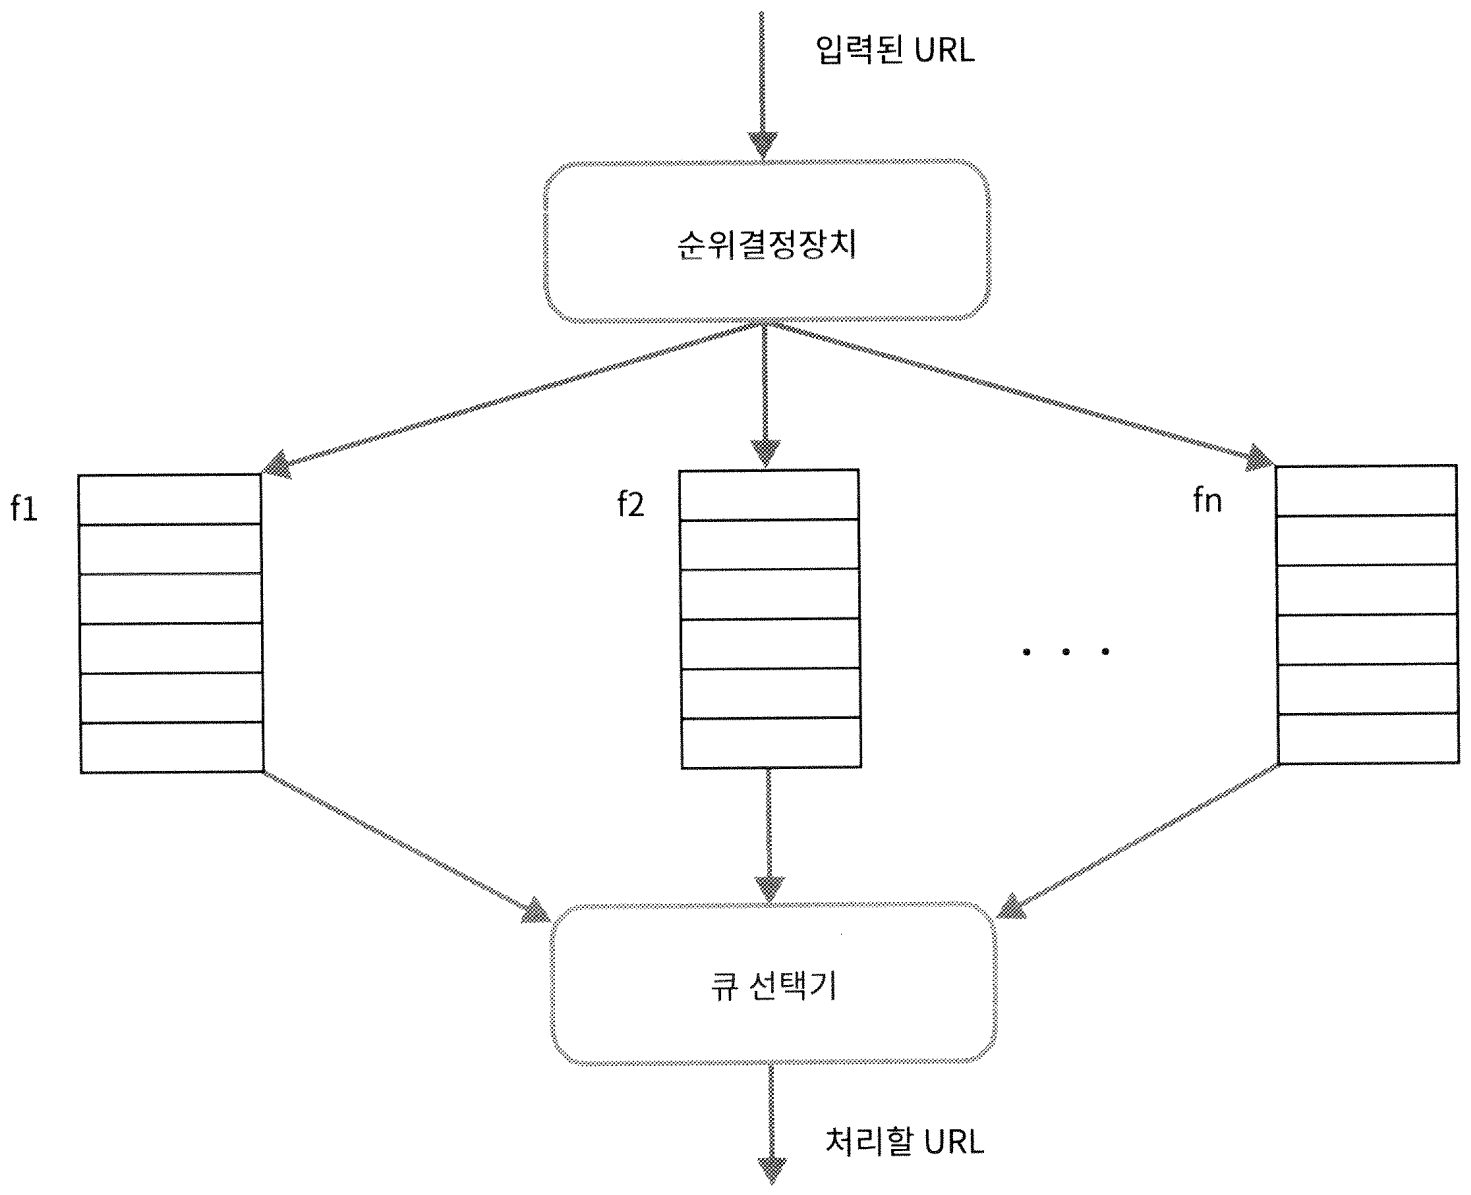
- URL 우선순위를 고려하여 변경한 설계
- 순위결정장치(Prioritizer)
- URL을 입력으로 받아 우선순위를 계산
- 큐
- 우선순위별로 큐가 하나씩 할당
- 우선순위가 높으면 선택될 확률도 올라감
- 큐 선택기
- 임의 큐에서 처리할 URL을 꺼내는 역할을 담당
- 순위가 높은 큐에서 더 자주 꺼내도록 프로그램 되어있음
- 전체 반영한 설계
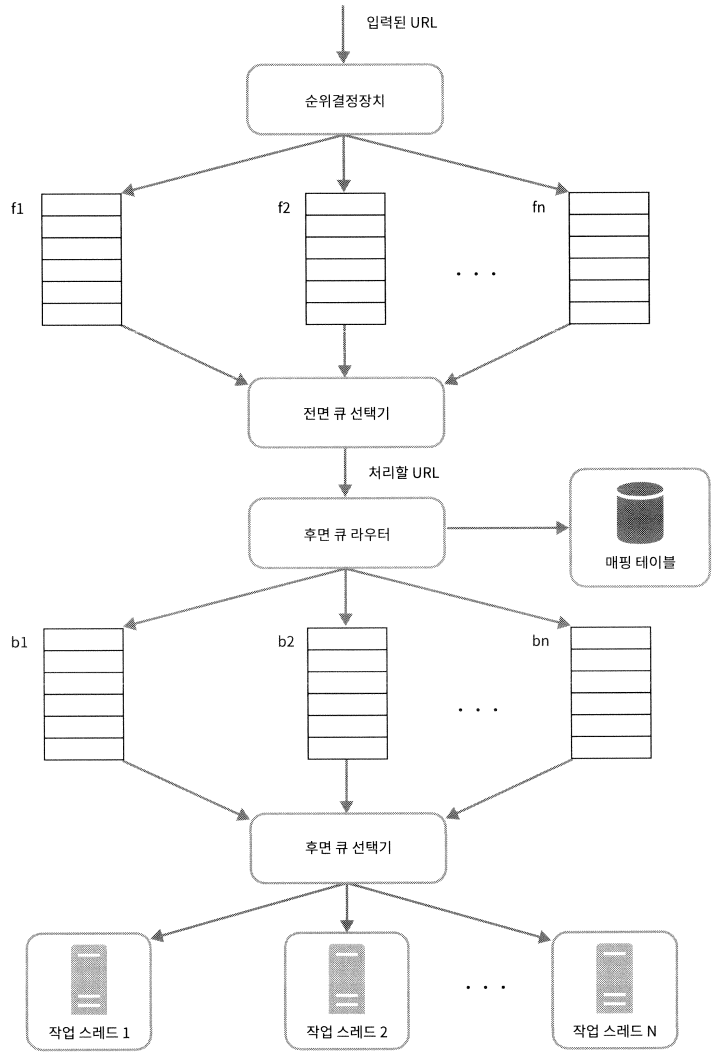
- 전면 큐
- 우선순위 결정 과정을 처리
- 후면 큐
- 크롤러가 예의 바르게 동작하도록 보증
- 전면 큐
- 신선도
- 데이터의 신선함을 유지하기 위해, 이미 다운로드한 페이지라도 주기적으로 재수집(Recrawl)할 필요가 있음
- 모든 URL을 재수집하는 것은 많은 시간과 자원이 필요하므로 최적화 전략이 필요
- 웹 페이지의 변경 이력(Update History) 활용
- 우선순위를 활용하여, 중요한 페이지는 좀 더 자주 재수집
- 미수집 URL 저장소를 위한 지속성 저장장치
- 검색 엔진을 위한 크롤러의 경우, 처리해야 하는 URL의 수는 수억 개에 달함
- 모두를 메모리에 보관하는 것은 안정성이나 규모 확장성 측면에서 바람직하지 않음
- 전부 디스크에 저장하는 것도 좋은 방법은 아님 → 느려서 쉽게 성능 병목지점이 되기 때문
- 절충안 선택(Hybrid Approach)
- 대부분의 URL은 디스크에 두지만 IO 비용을 줄이기 위해 메모리 버퍼에 큐를 두는 것
- 버퍼에 있는 데이터는 주기적으로 디스크에 기록
- HTML 다운로더
- HTTP 프로토콜을 통해 웹 페이지를 내려 받음
- 로봇 제외 프로토콜(Robot Exclusion Protocol)
- Robots.txt
- 웹사이트가 크롤러와 소통하는 표준 방법
- 크롤러가 수집해도 되는 페이지 목록이 들어 있음
- 크롤러는 해당 파일에 나열된 규칙을 먼저 확인
- 이 파일은 주기적으로 다시 다운받아 캐시에 보관
- 성능 최적화
- 분산 크롤링
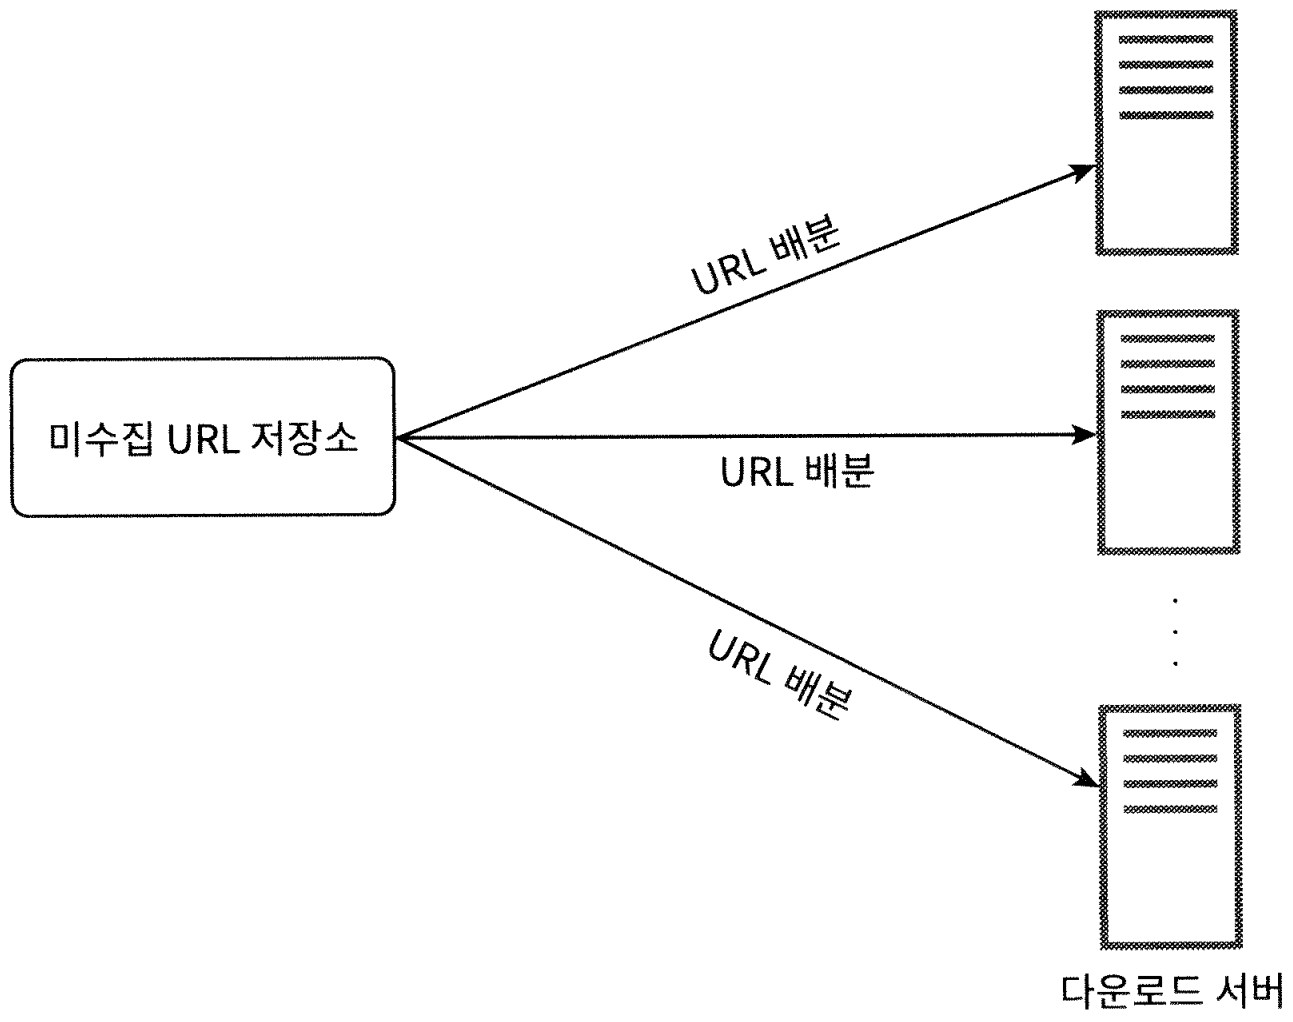
- 성능을 높이기 위해 크롤링 작업을 여러 서버에 분산하는 방법
- 각 서버는 여러 스레드를 돌려 다운로드 작업을 처리
- URL 공간은 작은 단위로 분할하여, 각 서버는 그 중 일부의 다운로드를 담당
- 도메인 이름 변환 결과 캐시
- 도메인 이름 변환기(DNS Resolver)는 크롤러 성능의 병목 중 하나
- DNS 요청을 보내고 결과를 받는 작업의 동기적 특성 때문
- 따라서 DNS 조회 결과로 얻어진 도메인 이름과 IP 주소 사이의 관계를 캐시에 보관해 놓고 크론 잡(Cron Job) 등을 돌려 주기적으로 갱신하도록 해 놓으면 성능을 효과적으로 높일 수 있음
- 지역성
- 크롤링 작업을 수행하는 서버를 지역별로 분산하는 방법
- 짧은 타임아웃
- 어떤 웹 서버는 응답이 느리거나 아예 응답하지 않음
- 대기 시간이 길면 좋지 않으므로, 최대 얼마나 기다릴지를 미리 정해두는 것
- 이 시간 동안 서버가 응답하지 않으면 크롤러는 해당 페이지 다운로드를 중단하고 다음 페이지로 넘어감
- 분산 크롤링
- 안정성
- 안정 해시(Consistent Hashing)
- 다운로더 서버들에 부하를 분산할 때 적용 가능한 기술
- 다운로더 서버를 쉽게 추가하고 삭제 가능
- 크롤링 상태 및 수집 데이터 저장
- 장애가 발생한 경우에도 쉽게 복구할 수 있도록 크롤링 상태와 수집된 데이터를 지속적 저장장치에 기록해 두는 것이 바람직
- 저장된 데이터를 로딩하고 나면 중단되었던 크롤링을 쉽게 재시작할 수 있음
- 예외 처리
- 대규모 시스템에서 에러는 불가피할 뿐 아니라 흔하게 벌어지는 일
- 예외가 발생해도 전체 시스템이 중단되는 일 없이 우아하게 이어나갈 수 있어야 함
- 데이터 검증(Data Validation)
- 시스템 오류를 방지하기 위한 중요 수단 가운데 하나
- 안정 해시(Consistent Hashing)
- 확장성
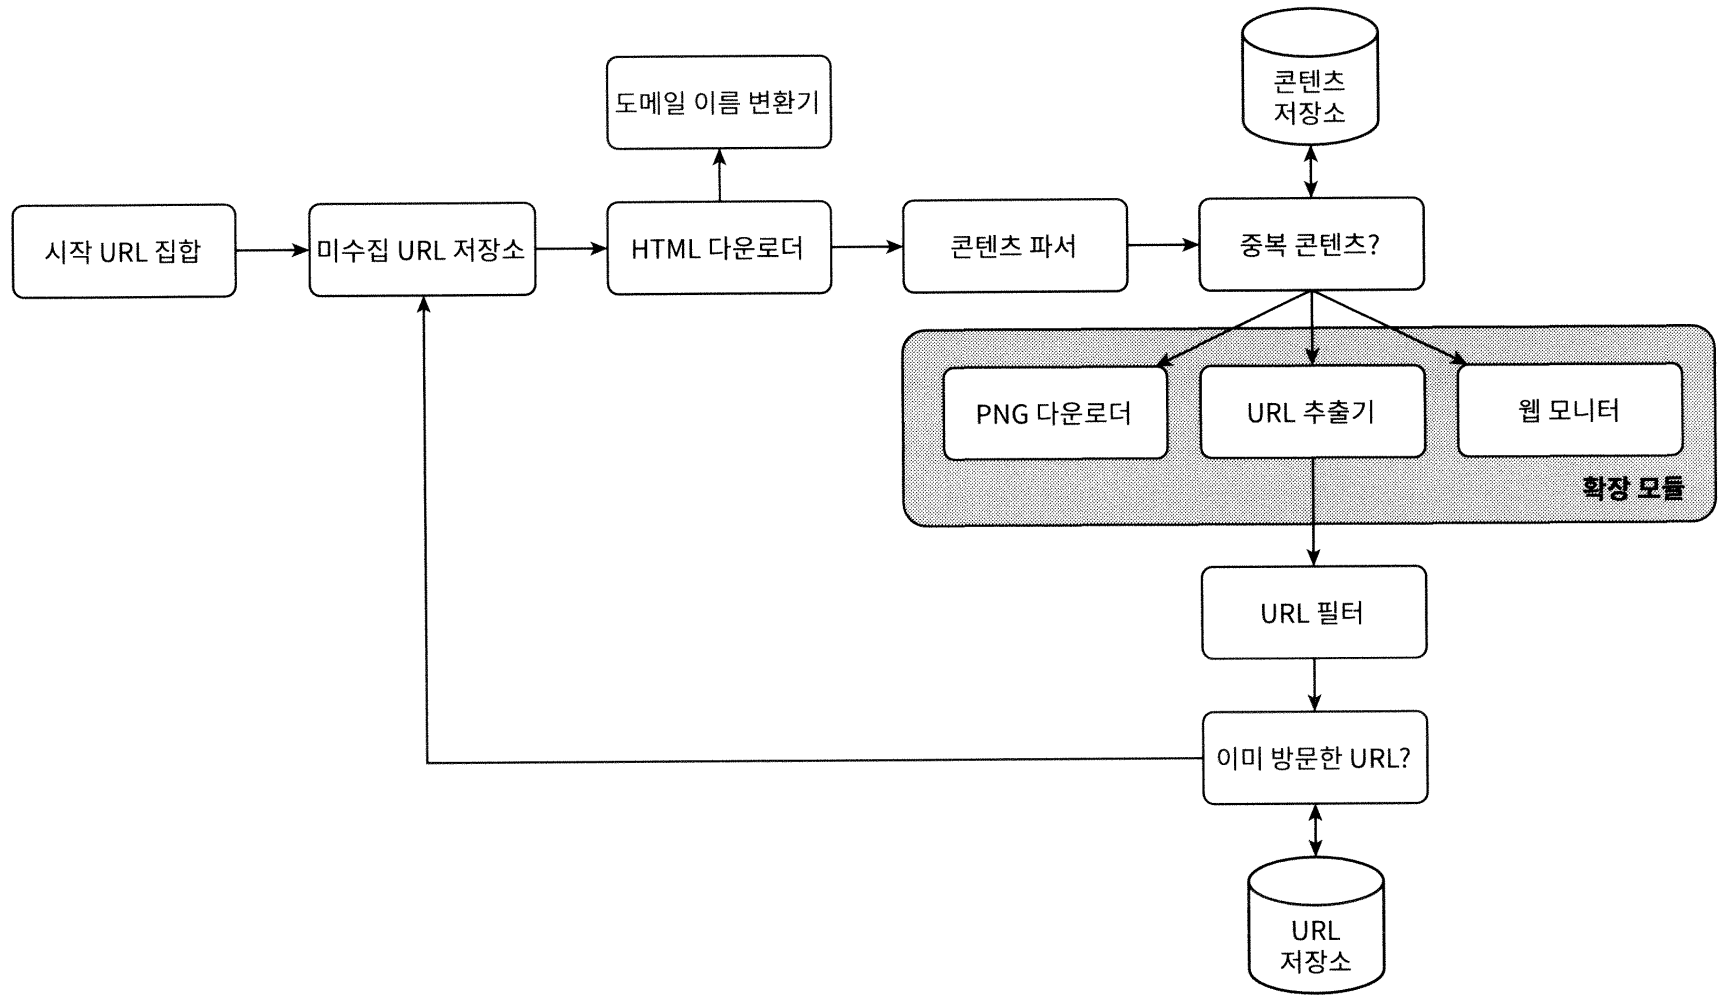
- 새로운 형태의 콘텐츠를 쉽게 지원할 수 있도록 신경 써야 함
- PNG 다운로더는 PNG 파일을 다운로드하는 플러그인 모듈
- 웹 모니터는 웹을 모니터링하여 저작권이나 상표권이 침해되는 일을 막는 모듈
- 문제 있는 콘텐츠 감지 및 회피
- 중복 콘텐츠
- 해시나 체크섬을 사용하면 중복 콘텐츠를 보다 쉽게 탐지
- 거미 덫(Spider Trap)
- 크롤러를 무한 루프에 빠뜨리도록 설계한 웹 페이지
- 무한히 깊은 디렉터리 구조를 포함하는 링크
spidertrapexample.com/foo/bar/foo/bar/foo/bar/…
- URL의 최대 길이를 제한하면 회피 가능
- 가능한 모든 종류의 덫을 피할 수 있는 만능 해결책은 없음
- 사람이 수작업으로 덫을 확인하고 찾아낸 후, 덫이 있는 사이트를 크롤러 탐색 대상에서 제외하거나 URL 필터 목록에 걸어두는 것
- 데이터 노이즈
- 어떤 콘텐츠는 거의 가치가 없음
- 가능하다면 제외
- 중복 콘텐츠
- DFS를 쓸 것인가, BFS를 쓸 것인가
- 마무리
- 보완할 점
- 서버 측 렌더링
- 많은 웹사이트가 자바스크립트, AJAX 등의 기술을 사용해서 링크를 즉석에서 생성
- 웹 페이지를 그냥 다운받아서 파싱하면 동적으로 생성되는 링크는 발견할 수 없음
- 페이지를 파싱하기 전, 서버 측 렌더링을 적용하면 해결
- 원치 않는 페이지 필터링
- 저장 공간 등 크롤링에 소요되는 자원은 유한함
- 스팸 방지(Anti-Spam) 컴포넌트를 두어 품질이 조악하거나 스팸성인 페이지를 걸러내도록 해 두면 좋음
- 데이터베이스 다중화 및 샤딩
- 다중화(Replication)나 샤딩(Sharding) 같은 기법을 적용하면 데이터 계층의 가용성, 규모 확장성, 안정성이 향상
- 수평적 규모 확장성
- 대규모의 크롤링을 위해서는 다운로드를 실행할 서버가 수백 혹은 수천 대 필요하게 될 수 있음
- 수평적 규모 확장성을 달성하는 데 중요한 것은 서버가 상태정보를 유지하지 않도록 하는 것
- 가용성, 일관성, 안정성
- 성공적인 대형 시스템을 만들기 위해 필수적으로 고려해야 하는 것
- 데이터 분석 솔루션(Analytics)
- 데이터를 수집하고 분석하는 것은 어느 시스템에게나 중요
- 서버 측 렌더링
- 보완할 점