가상 면접 사례로 배우는 대규모 시스템 설계 기초 - 11장
11. 뉴스 피드 시스템 설계
- 문제 이해 및 설계 범위 확정
- 모바일 앱과 웹 둘 다 지원
- 뉴스 피드 페이지에 새로운 스토리를 올릴 수 있어야 하고, 친구들이 올리는 스토리를 볼 수 있어야 함
- 시간 흐름 역순으로 표시
- 매일 천만 명이 방문한다고 가정
- 개략적 설계안 제시 및 동의 구하기
- 뉴스 피드 API
- 클라이언트가 서버와 통신하기 위해 사용하는 수단
- 피드 발행 API
- 새 스토리를 포스팅하기 위한 API
- 인자
- 바디(Body) : 포스팅 내용에 해당
- Authorization 헤더 : API 호출을 인증하기 위해 사용
- 피드 읽기 API
- 뉴스 피드를 가져오는 API
- 인자
- Authorization 헤더 : API 호출을 인증하기 위해 사용
- 피드 발행
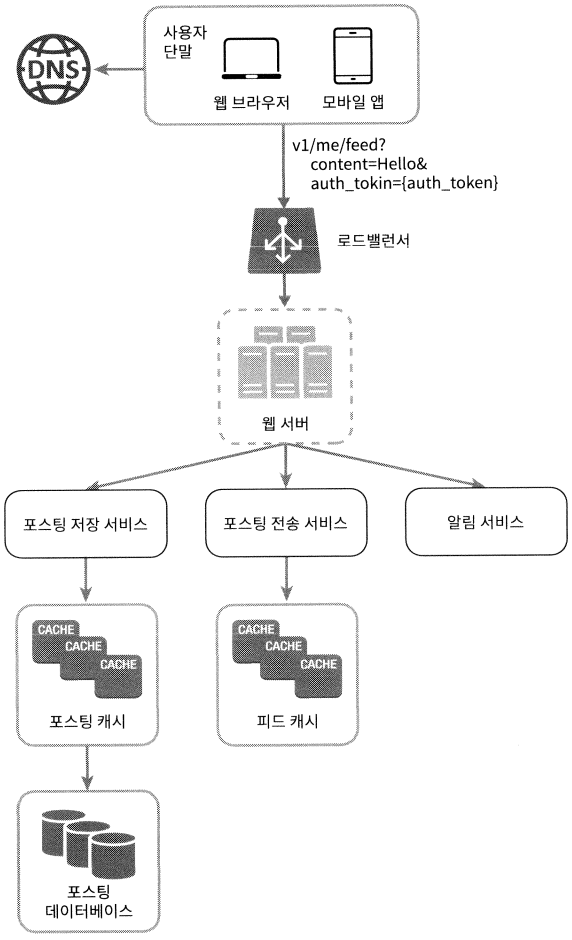
- 사용자 : 모바일 앱이나 브라우저에서 새 포스팅을 올리는 주체
- 로드밸런서 : 트래픽을 웹 서버들로 분산
- 웹 서버 : HTTP 요청을 내부 서비스로 중계
- 포스팅 저장 서비스 : 새 포스팅을 DB와 캐시에 저장
- 포스팅 전송 서비스 : 새 포스팅을 친구 뉴스 피드에 푸시. 뉴스 피드 데이터는 캐시에 보관하여 빠르게 읽어갈 수 있도록 함
- 알림 서비스 : 친구들에게 새 포스팅이 올라왔음을 알리거나, 푸시 알림을 보내는 역할
- 뉴스 피드 생성
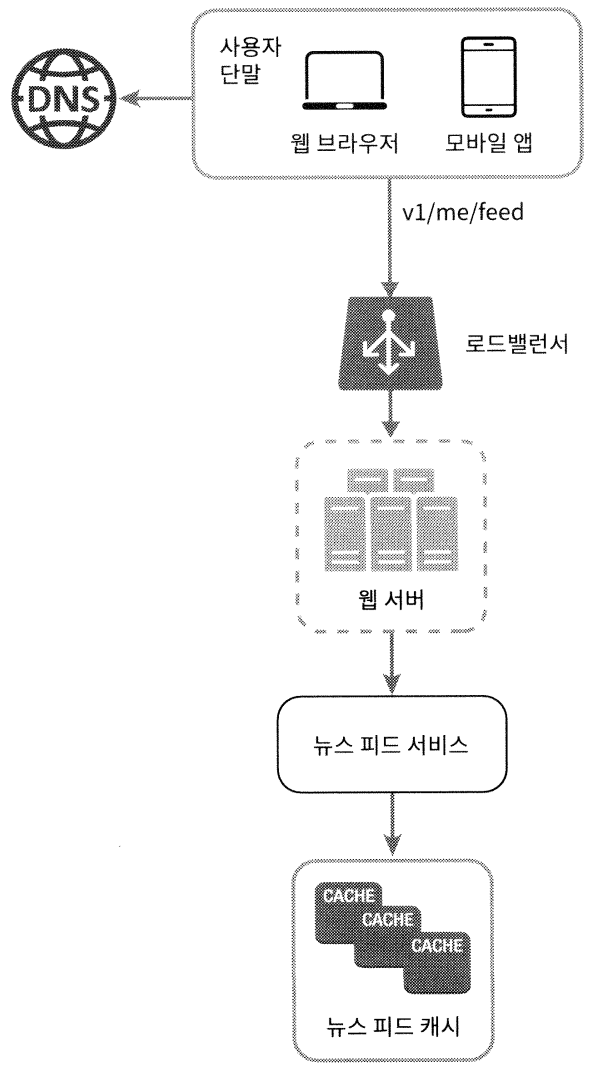
- 사용자 : 뉴스 피드를 읽는 주체
- 로드 밸런서 : 트래픽을 웹 서버들로 분산
- 웹 서버 : 트래픽을 뉴스 피드 서비스로 보냄
- 뉴스 피드 서비스 : 캐시에서 뉴스 피드를 가져오는 서비스
- 뉴스 피드 캐시 : 뉴스 피드를 렌더링할 때 필요한 피드 ID를 보관
- 뉴스 피드 API
- 상세 설계
- 피드 발행 흐름 상세 설계
- 웹 서버
- 클라이언트와 통신할 뿐 아니라 인증이나 처리율 제한 등의 기능도 수행
- 올바른 인증 토큰을 Authorization 헤더에 넣고 API를 호출하는 사용자만 포스팅을 할 수 있어야 함
- 스팸을 막고 유해한 콘텐츠가 자주 올라오는 것을 방지하기 위해서 특정 기간 동안 한 사용자가 올릴 수 있는 포스팅의 수에 제한을 두어야 함
- 포스팅 전송(팬아웃) 서비스
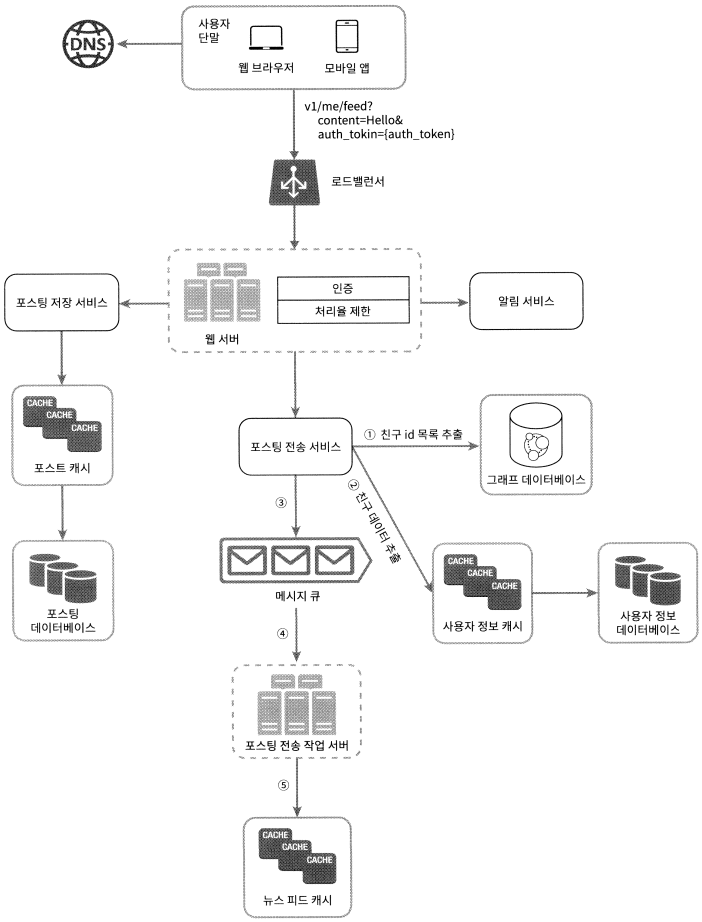
- 포스팅 전송(Fanout)은 어떤 사용자의 새 포스팅을 그 사용자와 친구 관계에 있는 모든 사용자에게 전달하는 과정
- 두 가지 모델이 있음
- 쓰기 시점에 팬아웃(Fanout-On-Write, Push 모델이라고도 함)
- 읽기 시점에 팬아웃(Fanout-On-Read)
- 쓰기 시점에 팬아웃
- 새로운 포스팅을 기록하는 시점에 뉴스 피드를 갱신하게 됨
- 포스팅이 완료되면 바로 해당 사용자의 캐시에 해당 포스팅을 기록
- 장점
- 뉴스 피드가 실시간으로 갱신되며 친구 목록에 있는 사용자에게 즉시 전송
- 새 포스팅이 기록되는 순간에 뉴스 피드가 이미 갱신되므로 뉴스 피드를 읽는 데 드는 시간이 짧아짐
- 단점
- 친구가 많은 사용자의 경우 친구 목록을 가져오고 그 목록에 있는 사용자 모두의 뉴스 피드를 갱신하는 데 많은 시간이 소요될 수 있음 → 핫키(Hotkey)라고 부르는 문제
- 서비스를 자주 이용하지 않는 사용자의 피드까지 갱신해야 하므로 컴퓨팅 자원이 낭비됨
- 읽기 시점에 팬아웃
- 피드를 읽어야 하는 시점에 뉴스 피드를 갱신
- 요청 기반(On-Demand) 모델
- 사용자가 본인 홈페이지나 타임라인을 로딩하는 시점에 새로운 포스트를 가져오게 됨
- 장점
- 비활성화된 사용자, 또는 서비스에 거의 로그인하지 않는 사용자의 경우 이 모델이 유리 → 로그인하기까지는 어떤 컴퓨팅 자원도 소모하지 않음
- 데이터를 친구 각각에 푸시하는 작업이 필요 없으므로 핫키 문제도 생기지 않음
- 단점
- 뉴스 피드를 읽는 데 많은 시간이 소요될 수 있음
- 팬아웃 모델의 두 가지 방법을 결합하여 장점은 취하고 단점을 버리는 전략
- 뉴스 피드를 빠르게 가져올 수 있도록 하는 것은 아주 중요하므로 대부분의 사용자에 대해서는 푸시 모델을 사용
- 친구나 팔로워가 아주 많은 사용자의 경우에는 팔로워로 하여금 해당 사용자의 포스팅을 필요할 때 가져가도록 하는 풀 모델을 사용하여 시스템 과부하를 방지
- 안정 해시를 통해 요청과 데이터를 보다 고르게 분산하여 핫키 문제를 줄여볼 것
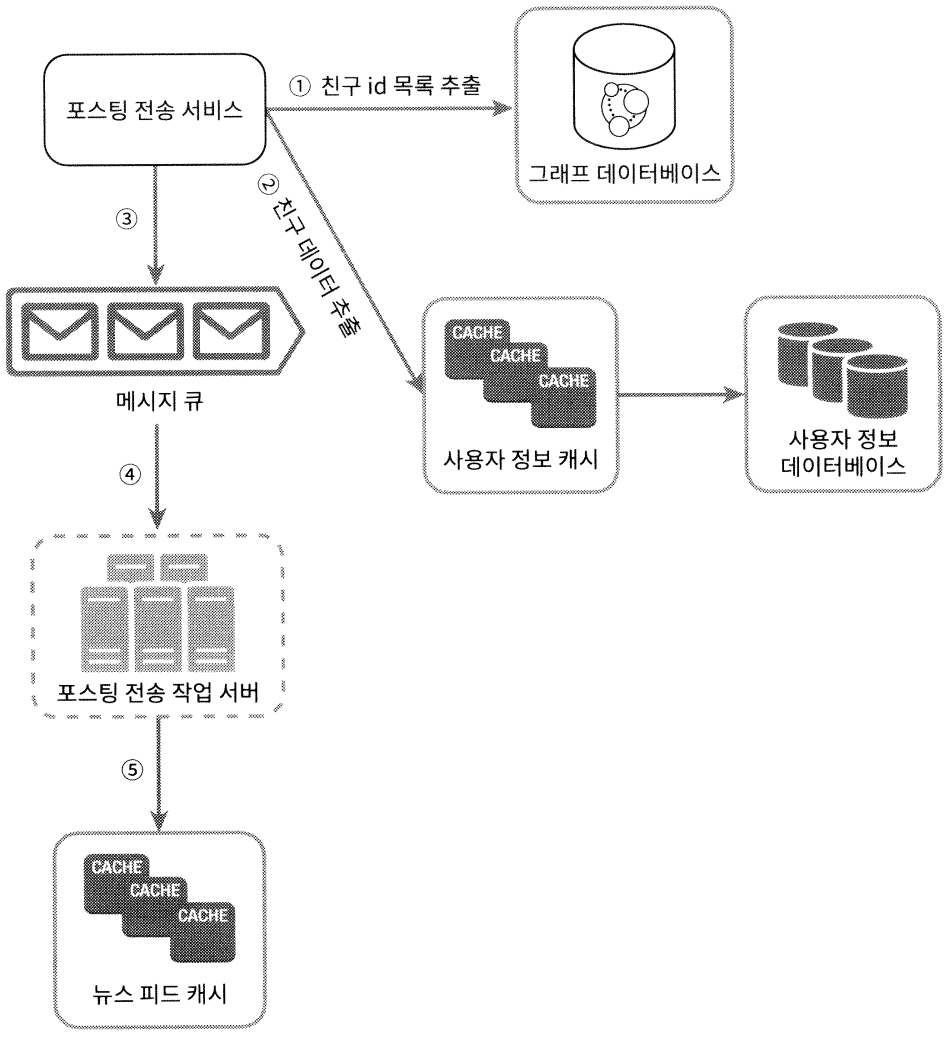
- 그래프 DB에서 친구 ID 목록을 가져옴 → 그래프 DB는 친구 관계나 친구 추천을 관리하기 적합
- 사용자 정보 캐시에서 친구들의 정보를 가져옴. 이후 사용자 설정에 따라 친구 가운데 일부를 거름
- 친구 목록과 새 스토리의 포스팅 ID를 메시지 큐에 넣음
- 팬아웃 작업 서버가 메시지 큐에서 데이터를 꺼내어 뉴스 피드 데이터를 뉴스 피드 캐시에 넣음
- 뉴스 피드 캐시는
<포스팅 ID, 사용자 ID>의 순서쌍을 보관하는 매핑 테이블. 따라서 새로운 포스팅이 만들어질 때마다 캐시에 레코드들이 추가 - 사용자 정보와 포스팅 정보 전부를 이 테이블에 저장하지 않는 이유는 메모리 요구량이 지나치게 늘어날 수 있기 때문. 따라서 ID만 보관
- 어떤 사용자가 뉴스 피드에 올라온 수천 개의 스토리를 전부 훑어보는 일이 벌어질 확률은 낮음 → 따라서 캐시 미스가 일어날 확률은 낮음
- 뉴스 피드 캐시는
- 웹 서버
- 피드 읽기 흐름 상세 설계
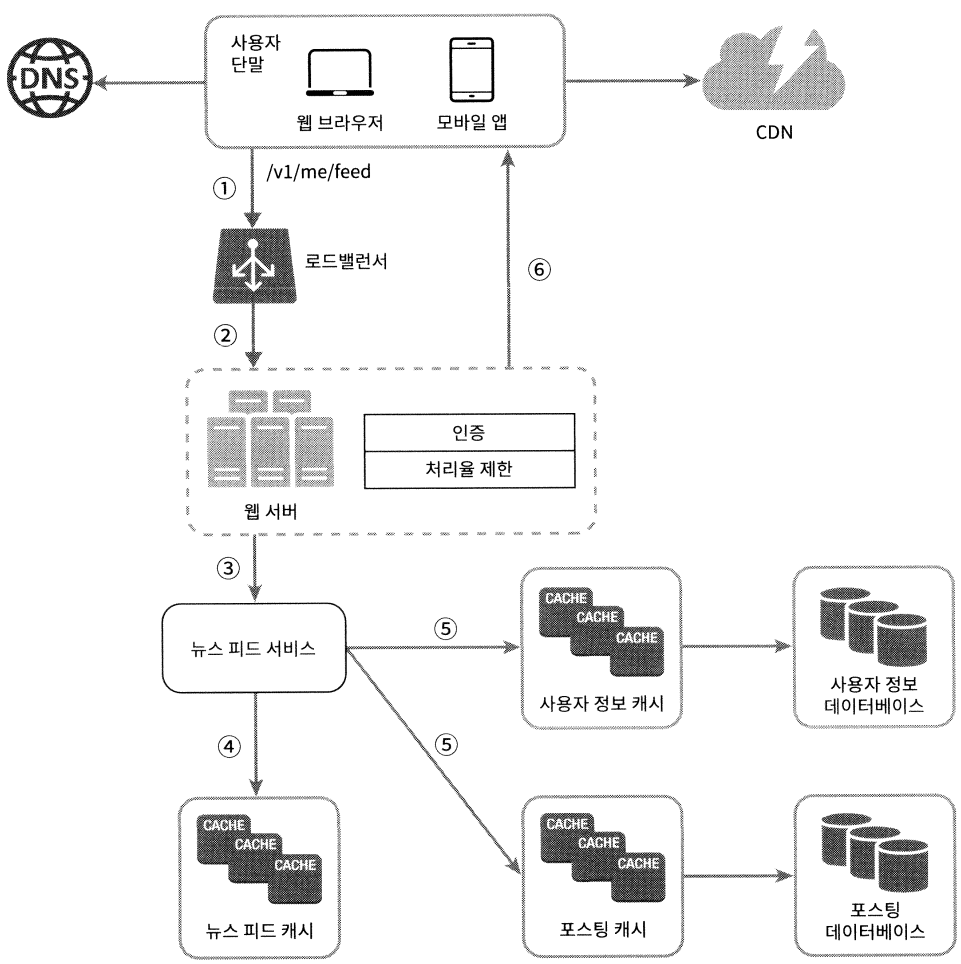
- 이미지나 비디오와 같은 미디어 콘텐츠는 CDN에 저장하여 빨리 읽어갈 수 있도록 함
- 클라이언트가 뉴스 피드를 읽어가는 단계
- 사용자가 뉴스 피드를 읽으려는 요청을 보냄
- 로드밸런서가 요청을 웹 서버 가운데 하나로 보냄
- 웹 서버는 피드를 가져오기 위해 뉴스 피드 서비스를 호출
- 뉴스 피드 서비스는 뉴스 피드 캐시에서 포스팅 ID 목록을 가져옴
- 뉴스 피드에 표시할 사용자 이름, 사용자 사진, 포스팅 콘텐츠, 이미지 등을 사용자 캐시와 포스팅 캐시에서 가져와 완전한 뉴스 피드를 만듬
- 생성된 뉴스 피드를 JSON 형태로 클라이언트에 보냄. 클라이언트는 해당 피드를 렌더링
- 캐시 구조
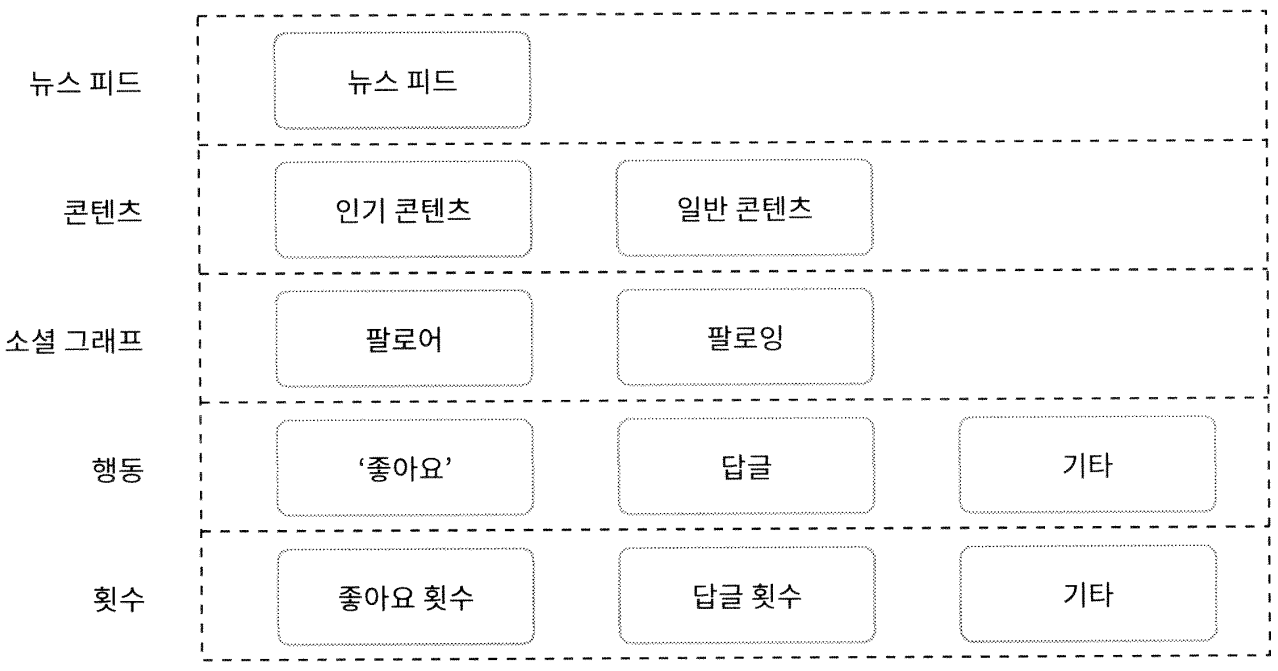
- 뉴스 피드 : 뉴스 피드의 ID를 보관
- 콘텐츠 : 포스팅 데이터를 보관. 인기 콘텐츠는 따로 보관
- 소셜 그래프 : 사용자 간 관계 정보를 보관
- 행동(Action) : 포스팅에 대한 사용자의 행위에 관한 정보를 보관. 포스팅에 대한 ‘좋아요’, 답글 등
- 횟수(Counter) : ‘좋아요’ 횟수, 응답 수, 팔로워 수, 팔로잉 수 등의 정보를 보관
- 피드 발행 흐름 상세 설계
- 마무리
- 보완할 점
- DB 규모 확장
- 수직적 규모 확장 vs 수평적 규모 확장
- SQL vs NoSQL
- 주-부 다중화
- 복제본에 대한 읽기 연산
- 일관성 모델
- DB 샤딩
- 웹 계층(Web Tier)을 무상태로 운영
- 가능한 한 많은 데이터를 캐시할 방법
- 여러 데이터 센터를 지원할 방법
- 메시지 큐를 사용하여 컴포넌트 사이의 결합도 낮추기
- 핵심 메트릭(Key Metric)에 대한 모니터링
- 트래픽이 몰리는 시간 대의 QPS, 사용자가 뉴스 피드를 새로고침 할 때의 지연시간 등
- DB 규모 확장
- 보완할 점